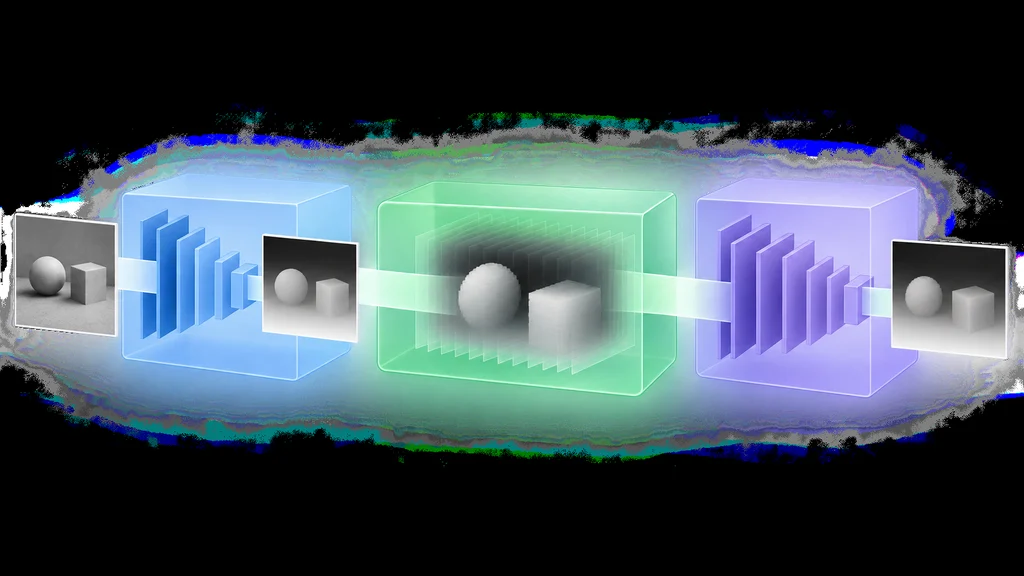
GPUで画像を処理するROS 2ノードが、標準メッセージを保ちながらGPU上のデータを次のノードへ渡せるようになった。NVIDIAが提供したCUDAバッファバックエンドは、条件が合うノード間でCPUメモリーを経由するコピーを省く。
GPUで処理しても残っていたノード間のコピー
ROS 2でGPUによる画像処理を高速化しても、ノード間でメッセージを渡す際にはデータがCPUメモリーを経由し、シリアライズやコピーが生じる場合がある。処理本体をGPU上で実行していても、その前後の受け渡しが別のデータ移動を必要としていた。
NVIDIAが提供したCUDAバッファ経路は、この受け渡しを変更する。標準のROS 2メッセージとノードの境界を維持したまま、条件が合う発行側と購読側でGPU上のデータ本体を共有する。
標準メッセージの配列をCUDAの記憶領域につなぐ
ROS 2 Lyricalでは、メッセージに含まれる可変長の基本型配列を、生成されるC++コードでrosidl::Bufferとして扱う。この仕組みにより、配列の記憶領域を切り替えても、別のメッセージ型を定義する必要はない。
CUDAバッファバックエンドは、CUDA Virtual Memory Managementを使ってその記憶領域を実装する。同じホスト、CUDAデバイス、Linuxユーザーを使い、対応するRMW実装を備えるノード間では、データ本体をシリアライズしたりホストメモリーへコピーしたりせずに受け渡せる。
接続相手に合わせてCPU経路へ切り替える
CUDAバッファ経路の条件を満たさない相手には、既存のROS 2ノードと互換性があるCPU経路へ自動的に切り替わる。このため、GPU上のデータを共有できるノードと、CPUメモリーを使うノードを標準メッセージのまま接続できる。
NVIDIAによると、ロボット向けソフトウェア群のNVIDIA Isaac ROS 5.0では、全ノードをCUDAバッファバックエンドを使うよう更新した。GPU上で処理する各ノードの間にも、新しいデータ転送経路を適用した構成となる。
深度画像ノードで推論結果を出力バッファへ直接書く
既存ノードの移行では、計算処理だけでなく、入力から発行までのデータ移動を追う必要がある。NVIDIAが示したAIコーディングエージェントの作業手順は、その経路を調べ、メッセージのインターフェースを保つ変更とCUDA転送経路の確認を支援する。
移行例のDepth Anything 3 TensorRT ROS 2ノードは、入力画像から単眼の距離を推定し、浮動小数点の深度画像を発行する。変更後は購読設定でCUDAバッファを受け入れ、TensorRTの推論結果を出力メッセージのCUDAバッファへ直接書き込む。
転送経路をメモリーコピーとバッファ種別で確かめる
NVIDIAが示した確認方法では、Nsight Systemsを使い、ROSの境界にデータ本体相当のホスト・デバイス間転送がないことを調べる。発行側と購読側がCUDA経路の条件を満たす場合には、購読したメッセージのバッファ種別が「CUDA」と報告されることも確認する。