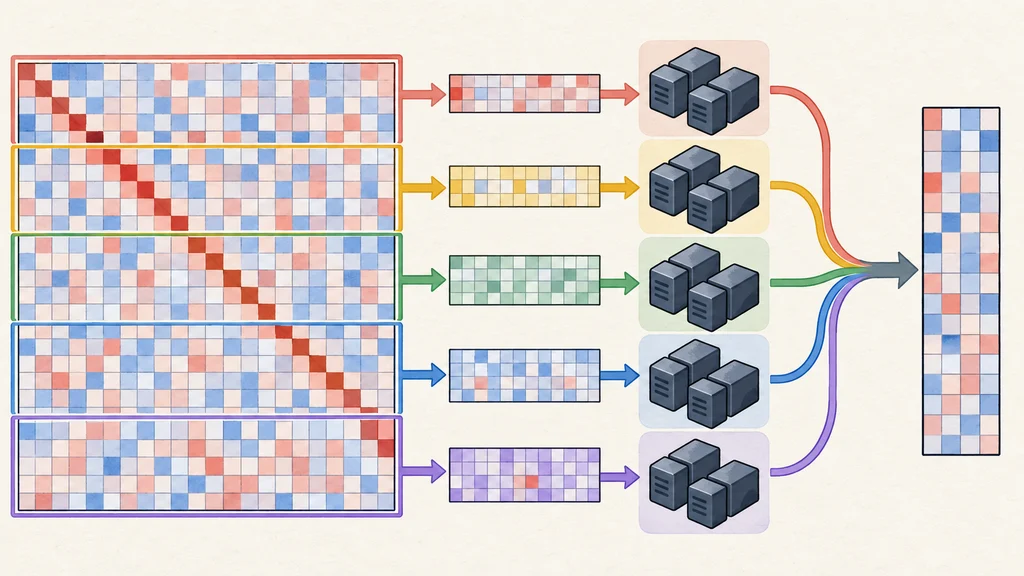
合成データから作った金融商品100万件の相関行列を、64基のGPUで約2分かけて因子分解したとNVIDIAは報告した。中間行列を省く計算式と行単位の分散処理が、大きな依存行列を扱うための核となる。
二つの依存行列から所属度とクラスタを得る
ローリングした金融商品のリターンから、通常の値動きを捉える絶対値付きのPearson相関行列と、極端な変動時の関係を捉えるTPDMを作る。両方の行列を対称非負行列分解の入力にすることで、同じ処理経路から異なる依存関係を調べられる。
因子分解で得られる行列の各行には、一つの金融商品が各因子にどの程度結び付くかが非負の値で並ぶ。この因子負荷量を残せば段階的な所属を扱え、最大値の因子を選べば商品ごとに一つのクラスタラベルを付けられる。
固有値による更新選択と中間行列の削減
GPU向けの因子分解ソルバーAdaptGrowは、入力行列の固有値スペクトルを調べ、全行列を使うAdaGrad更新と、ブロックを抽出するSVRG更新から初期の計算経路を選ぶ。スペクトル上の分離が明瞭な行列と平坦な行列を、一つのソルバーで処理する構成だ。
計算時には、中間の密行列を生成しない式を使う。これにより推定ピーク記憶量は約20n²バイトから約4n²バイトと小さな因子バッファへ減る。金融商品約10万件のFP32依存行列は約40GBで、入力行列はGB200の1基に収まる。ただし、この規模の実行時間測定には4基のGB200が使われた。
行分割で100万件の行列を64基のGPUへ載せる
さらに大きな行列では、依存行列を行単位でGPUへ分け、因子行列を各ワーカーに複製する。行列と因子の積および勾配を集約する際の通信は、依存行列全体に相当するO(n²)ではなくO(nk)のデータで済む構成となる。
金融商品100万件の約4TBの行列は、16ノードにある64基のGB200へ分散された。NVIDIAの測定では、全行列版AdaGradによる相関行列の因子分解が約2分、AdaptGrowによるTPDMの因子分解が約4分で完了した。いずれも個別の因子分解の時間であり、全時系列窓の処理時間ではない。
公開されたSymNMF-factorsのリポジトリには、単一GPU用ソルバーに加え、行分割済み行列を複数GPUで扱う実装と、金融用途の処理をたどれる実演ノートブックが含まれる。
250個の窓で所属変更を検出する
時系列の評価には、所属グループを変更する商品と、所属を変えずに共同で極端な下落を起こすグループを埋め込んだ合成リターンを使った。処理はこれを250個のローリング窓に分け、それぞれの窓でクラスタを求める。
所属変更の判定には、クラスタの一致度を表すARIを使う。隣り合う窓ではなく、窓幅に相当する50ステップ離れた結果を比べ、平穏な窓から求めた3σの管理限界を下回る変化として、埋め込んだ所属変更を検出した。
所属が変わらない共同下落はTPDMに現れる
共同下落は所属グループの変更を伴わないため、クラスタラベルの変化だけでは捉えにくい。合成データで下落が最大となった時点では、対象グループ間の依存度は相関行列で約0.04だったのに対し、極端な変動を測るTPDMでは約0.13だった。
単一ラベルへまとめる処理には、境界にある商品の所属度も失われる。合成実験では約9%の商品がクラスタの境界に位置し、SymNMFの因子負荷量は複数グループへの段階的な所属を保持した。