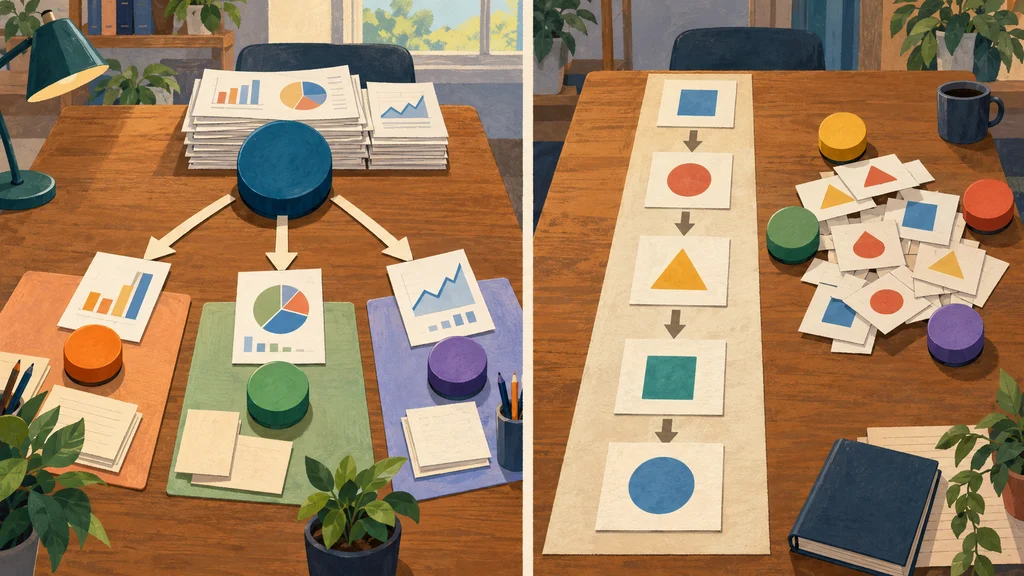
複数のAIエージェントを協調させる効果は、課題を並列に分割できるかで変わる。Googleによる180構成の評価では、中央集約型が金融推論の性能を高めた一方、逐次的な計画課題では複数エージェントの全方式が単一方式を下回った。
作業の割り当てと結果の統合を5方式で比較
推論や計画、行動を担うAIエージェントは、単独で処理する場合と、部分課題を複数に割り振る場合で情報の受け渡し方が変わる。Googleはこの違いを調べるため、180構成を制御された条件で評価し、単一、独立型、中央集約型、分散型、混合型の5方式を比較した。評価対象は金融推論、Web探索、計画、ツール利用の4種類だった。
単一方式では、一つの記憶の流れに沿って推論と行動を逐次実行する。独立型では、エージェント間で通信せずに部分課題を並列処理し、最後に結果を集める。中央集約型では調整役が課題を割り当て、作業エージェントから返された出力を統合する。
金融推論では分担が効き、逐次計画では通信が負担に
Googleの評価では、並列化できる金融推論課題で中央集約型の性能が単一エージェント比80.9%向上した。この課題では、収益動向、費用構造、市場比較などの分析を別々のエージェントが同時に進めることができる。Googleは、こうした部分課題への分割が性能向上を支えたと説明している。
厳密な逐次推論を必要とする計画ベンチマークのPlanCraftでは、評価した全ての複数エージェント方式が単一方式を下回り、性能は39~70%低下した。Googleは、通信の負担が推論の流れを分断し、課題そのものに使える処理の余裕を減らすと説明している。
調整役による検証が誤りの伝播を抑える
結果の集約方法は、エージェントの誤りが最終結果へ伝わる度合いにも関わる。Googleが測定した誤りの増幅倍率は、エージェント同士が通信しない独立型で17.2倍、調整役を置く中央集約型で4.4倍だった。
Googleは、中央集約型の調整役が出力を検証し、誤りが伝播する前に捉えると説明している。部分課題の出力を統合する段階に検証を組み込むことが、測定された増幅の抑制につながったとしている。
ツール数と分割しやすさから協調方式を予測
課題によって性能差の向きが変わるため、Googleは課題特性を入力にして協調方式を選ぶ予測モデルを開発した。このモデルはツール数や課題の分割しやすさを使い、最も高い性能を得る方式を予測する。
予測の評価には、モデルにとって未見の課題構成を使った。その87%で、最適な協調方式を特定した。