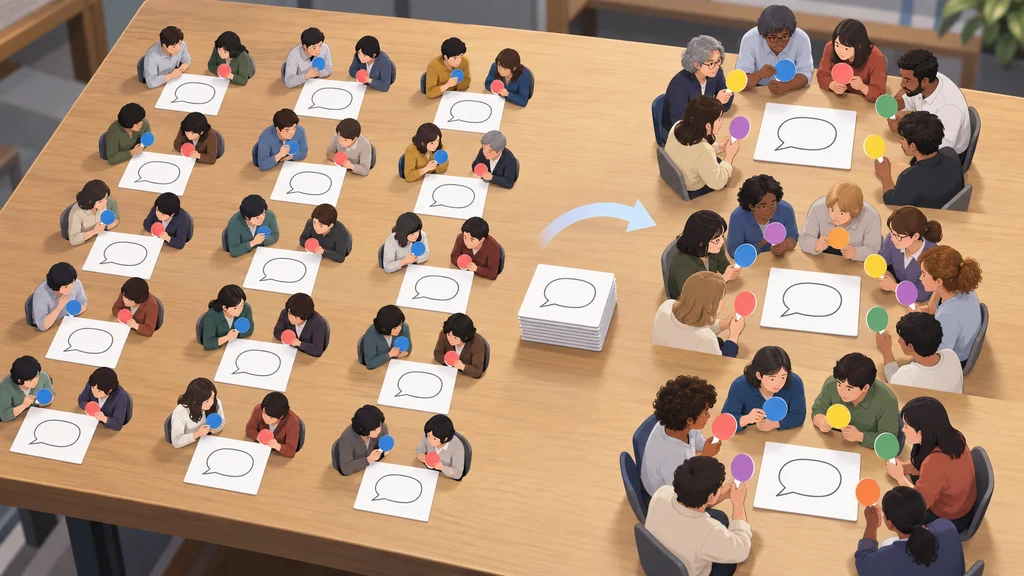
AI評価に使う人手は、何を測るかによって有効な配分が異なる。Googleのシミュレーションでは、人の多数派との一致を測るなら評価対象を広げ、意見の幅を捉えるなら一つの対象を評価する人数を増やす方が有効だった。
一つの正解ラベルでは消える判断のばらつき
有害な発言かどうかなど、人によって判断が分かれる課題では、最多票のラベルだけを正解として残すと意見のばらつきが失われる。同じラベルが選ばれても、それを強く支持する評価と、賛否が割れた評価の違いを表せなくなる。
Googleは、人による参照評価データを使い、評価対象数と対象ごとの評価者数の配分を検討する枠組みを開発した。多数の対象を少人数で評価する配分と、少数の対象を多人数で評価する配分を、モデル評価の再現性という観点から比較する。
実データから数千通りの人手配分を検証
配分の比較には、有害性やヘイトスピーチの検出など、主観的な判断を含む実データに基づくシミュレーターを使った。対象ごとの評価者数を1~500人の範囲で変え、評価対象数との数千通りの組み合わせを検証した。
シミュレーターでは、性能差がある二つのモデルを比較する。その差を評価結果から判別できるかを調べるため、p値が0.05未満になることを統計的な判定基準に用いた。
多数派との一致と意見の幅では有効な配分が異なる
Googleの検証では、モデルの出力が人の多数派の判断と一致するかを測る場合、一般に評価者数を増やすより評価対象数を増やす方が有効だった。一方、人の意見の幅を捉える場合は、一つの対象を評価する人数を増やす方が有効だった。
人の判断の違いを反映した信頼性の高い結果を得るには、対象ごとに1人、3人、5人を割り当てる一般的な配分ではしばしば不十分だった。10人を超える評価者が必要になる場合が多いという結果も得られており、少人数の評価で意見の幅を代表できるという前提には見直しを迫る。
総評価約1,000件でも高い再現性を得られる条件
必要な人手は、対象ごとの人数だけで決まるわけではない。Googleのシミュレーションでは、測る指標に合わせて配分を最適化すると、総評価件数が約1,000件でも高い再現性を得られる条件があった。
この約1,000件は評価者の人数ではなく、評価を行った総件数を指す。人手配分の検証に用いたシミュレーターは、GitHubでオープンソースとして公開された。