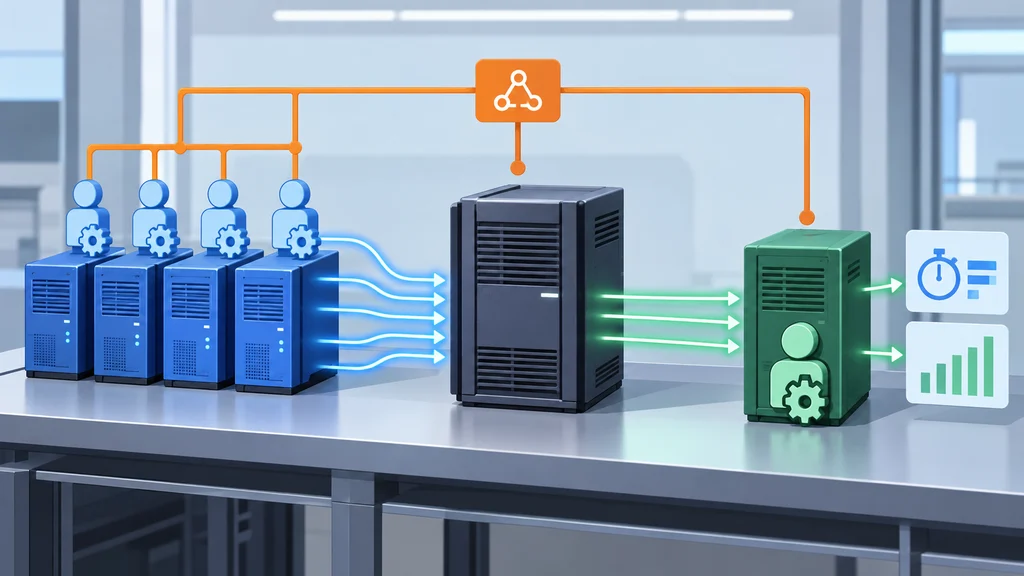
LLM推論の負荷試験ツールAIPerfは、要求の送信と結果の処理を複数プロセスへ分ける構成になった。NVIDIAは、測定クライアント側が高い同時実行数で処理の制約になることを避ける設計だと説明している。
負荷生成と結果処理を別のプロセスへ
NVIDIAのLLM推論負荷試験ツールAIPerfは、GenAI-Perfの後継として作られた。従来のツールが利用していたPerf Analyzerの上では動作せず、負荷試験クライアントの構成を改めている。
ワーカープロセスが推論サーバーへ要求を送り、別の結果処理サービスが返ってきた記録を扱う。各処理はZMQを介して協調するため、要求の生成と測定結果の処理を一つのプロセスへ集中させない構成になっている。
接続先と要求の到着パターンを選ぶ
AIPerfはチャット、Responses API、画像生成を含む15種類以上のエンドポイントに対応する。入力にはShareGPTなどの公開データセットを使えるほか、Mooncake、Baseten、WEKA AgentXの形式で記録されたトレースを再生できる。
要求を送る間隔は一定にすることも、ポアソン分布やガンマ分布に従わせることもできる。同時実行数と要求率を段階的に増やす設定もあり、接続先だけでなく、サーバーへ与える負荷の時間的な形を変えられる。
要求長とストリーミングをそろえて測る
NVIDIAが示した実行例では、入力と出力をそれぞれ128トークン、標準偏差を0に設定し、要求ごとの長さを固定する。さらにmin_tokensとignore_eosを指定し、モデルが目標の128トークンより前に生成を終えないようにしている。
応答はストリーミングで受け取る。この設定によって、要求を送ってから最初のトークンが届くまでの時間と、後続トークンの間隔を測定できる。
遅延の分布と推論トークンの時刻を読む
AIPerfは初回トークンまでの時間、トークン間の遅延、要求全体の遅延、出力トークンのスループットを報告する。測定値は百分位数でも表示され、実行結果はCSVとJSONに書き出される。
推論トークンを返すモデルでは、初回トークンまでの時間を示すTTFTに推論トークンも含まれる。一方、TTFOは最初の通常の出力トークンまでの時間を示すため、両者を分けて生成の経過を確認できる。