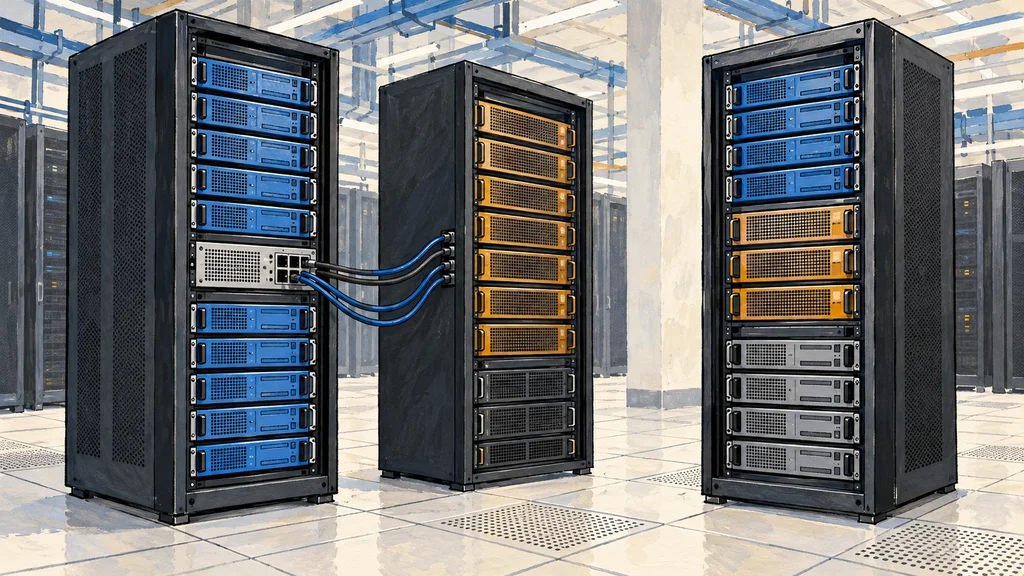
AIエージェントの実行を担うCPUと、モデル推論を担う基盤を分けるか、同じラックへまとめるかを選ぶ。AMDのラック参照設計Helionは、CPU単独とCPU・GPU一体型の構成を用意した。実機のラック構成はパートナーと開発中で、2026年11月の提供を予定する。
モデル呼び出しを振り分けるラック参照設計
AMDが公開したAIエージェント向けラック参照設計AMD Helionは、Open Compute Project(OCP)の仕様を基礎とする。モデル呼び出しの振り分けを担うトークンルーターを組み込み、エージェントからの呼び出しを最先端モデルやオープンソースモデルへ送る構成だ。
CPU単独ラックは別のモデル推論基盤へ接続
モデル推論を別の基盤に任せる場合、CPU単独ラックがエージェント実行専用の計算容量を担う。AMDは大規模クラウド事業者向けにこの構成を想定しており、第6世代のサーバー用プロセッサーAMD EPYCによって、1ラックに最大32,768個のCPUコアを搭載できる設計としている。この上限は設計上の搭載容量である。
企業向けにはCPUとGPUを同じラックへ
企業向けの一体型構成では、EPYCのCPUノード、計算用GPUであるAMD Instinct MI350Pのノード、汎用計算を一つの基盤へ組み合わせる。エージェント実行、モデル推論、それらを支える計算を同じラックに収める設計だ。AMDは、パートナーが顧客の処理内容に応じてCPUとGPUの構成を調整し、性能・電力・コストの要件に対応するものと位置付けている。
空冷と液冷に対応し、11月の提供を予定
ラック参照設計は、冷却方式にも空冷と液冷の選択肢を持つ。AMDは仕様をOCPへ提供する計画で、コミュニティーによる開発と採用につなげる方針だ。ラック構成はパートナーと開発中で、提供は2026年11月を予定している。