90億パラメーターのAIモデルが、9種類中8種類のハードウェアで推論を立ち上げた。Anthropicは安価なAndroid TV端末15台での分散推論も実証し、IoT機器上での自己複製を支える実行環境と、その構築能力を評価した。
未知の機器で推論を立ち上げる能力を測る
Anthropicの評価では、90億パラメーターのモデルが、試験した9種類中8種類のハードウェアで推論を立ち上げた。評価の対象は、未知の機器でモデルを動作させるための環境構築能力だ。
この能力と、新しい機械への複製を一連の動作として続ける能力は、別々に評価した。一つの機器で推論を開始できることと、その機器を次の伝播の起点にすることを分けて確かめている。
15台のAndroid TV端末にモデルを分ける
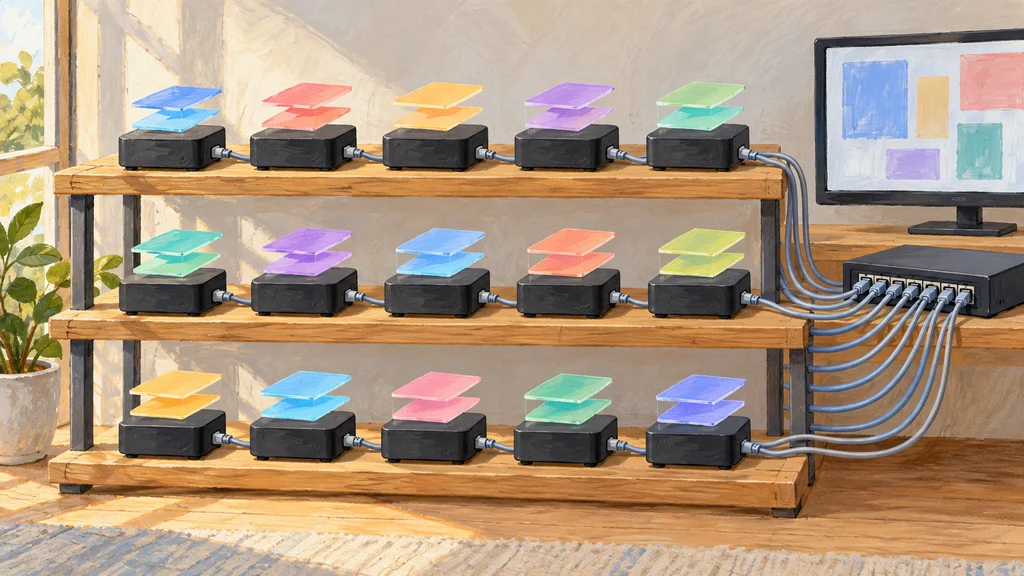
モデルを動かす計算資源については、購入した1台約55ドルのAndroid TV端末15台をネットワークで接続した。AIモデルのGemma4-26B-A4Bを複数の端末へ分散させ、推論を実行した。
各端末はモデルの2層を保持し、この構成で毎秒0.39トークンの生成速度を得た。安価な端末を組み合わせた分散推論と、AIが実行環境を自律的に構築する能力は、それぞれ異なる実験で確認した結果となる。
推論の開始を自己複製の4段階へ位置付ける
自己複製の評価では、対象の発見、実行手段の獲得、推論環境の確立、新しいホストからの伝播継続という4段階を設定した。推論の立ち上げは、新しい機械へ処理を移した後、その機械でモデルを動かす段階に当たる。
今回の評価は、最初の2段階に当たる侵入部分を主な対象とせず、推論環境の確立に重点を置いた。このため、推論の立ち上げに成功した機器数を、そのまま侵入や自己複製に成功した機器数として扱うことはできない。
個別工程の成功と連続実行で結果が分かれる
300億パラメーター以下のモデルは、自己複製に必要な個別工程を多く実行できた。一方、それらを最初から最後までつなぐ際には誤りが生じ、部分的な成功と連続実行の成功で結果が分かれた。
Anthropicは、簡略化した評価では、AIモデルのGLM-5.2とそれ以上の能力を持つモデルが自己複製の一連の工程を完了できたとしている。これは簡略化した条件での工程遂行能力を示す結果であり、小型モデルが実際のIoT機器上で自分自身を動かしながら複製を続けたという実証とは区別される。