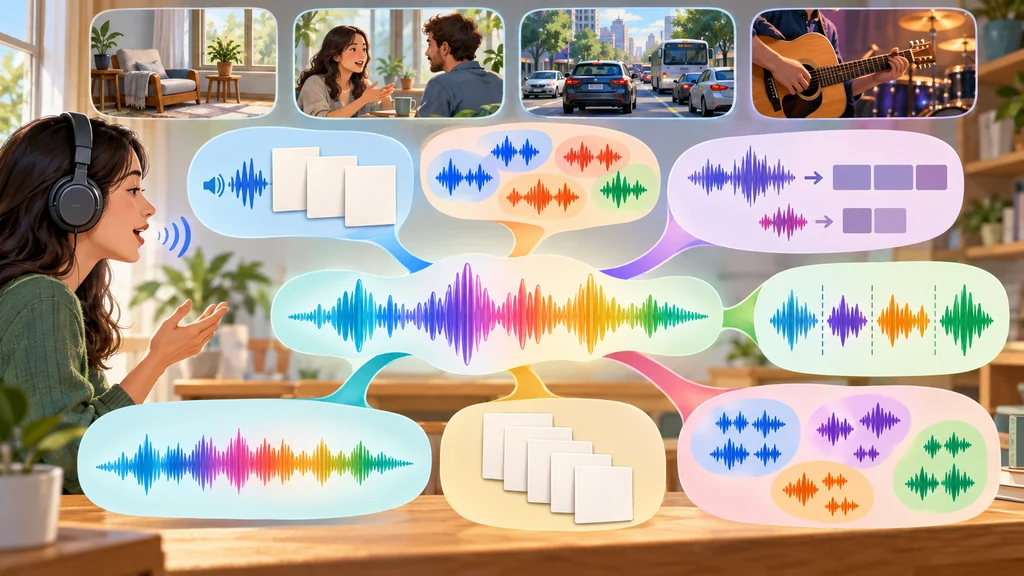
音声AIの評価対象が、文字起こしの正確さから、検索や推論、元の波形を再現する能力まで広がった。評価基盤MSEBは音の中間表現を8種類の能力で比較し、Googleの初期実験では、すべての課題で改善余地が認められた。
音の中間表現を8種類の出力で調べる
Googleが開発した音の評価基盤Massive Sound Embedding Benchmark(MSEB)は、音を変換した中間表現である埋め込みを、異なる用途にまたがって評価する。対象は検索、推論、分類、文字起こし、区間分割、クラスタリング、再順位付け、波形再構成の8種類だ。
評価課題は音を入力とし、テキストの文脈や知識ベースも組み合わせる。検索では音声の質問に対応する文書や文章を探し、波形再構成では埋め込みから元の音声波形を再生成したときの忠実度を調べる。
17言語の質問を4種類の音響環境で収録
こうした音声質問の評価を支えるのが、Googleが収集して公開したデータセットSimple Voice Questions(SVQ)だ。26のロケール、17言語にわたる177,352件の短い質問を収録している。
収録環境は、雑音のない環境、背景の会話、交通騒音、メディアの音の4種類に分かれる。音声には話者属性に加え、重要な語句がいつ現れるかを示す時間位置の情報も付いている。
正解テキストと専用手法を比較基準にする
異なる音声処理方式も、MSEBでは共通の評価枠組みに載せることができる。複数の処理をつなぐカスケード型システムから、エンドツーエンドの音声エンコーダーまでを対象にしている。
Googleは比較基準を課題の性質に応じて分けた。意味を扱う課題では正解テキストを入力した場合と比べ、それ以外の課題では既存の専用手法を基準にして、汎用的な音の表現に残る改善余地を評価した。
文字起こしが後続処理の意味情報を制約
Googleの初期実験では、既存の音の中間表現は8種類すべての課題で改善余地を残した。評価した表現は、各能力を一様に満たす汎用的な表現には達していないという結果だった。
特に検索、推論、再順位付けでは、自動音声認識(ASR)の段階が性能の制約となった。音声を文字へ変換してから後続処理へ渡す経路で意味情報が失われ、文字起こしの影響が下流の課題にも及んだ。