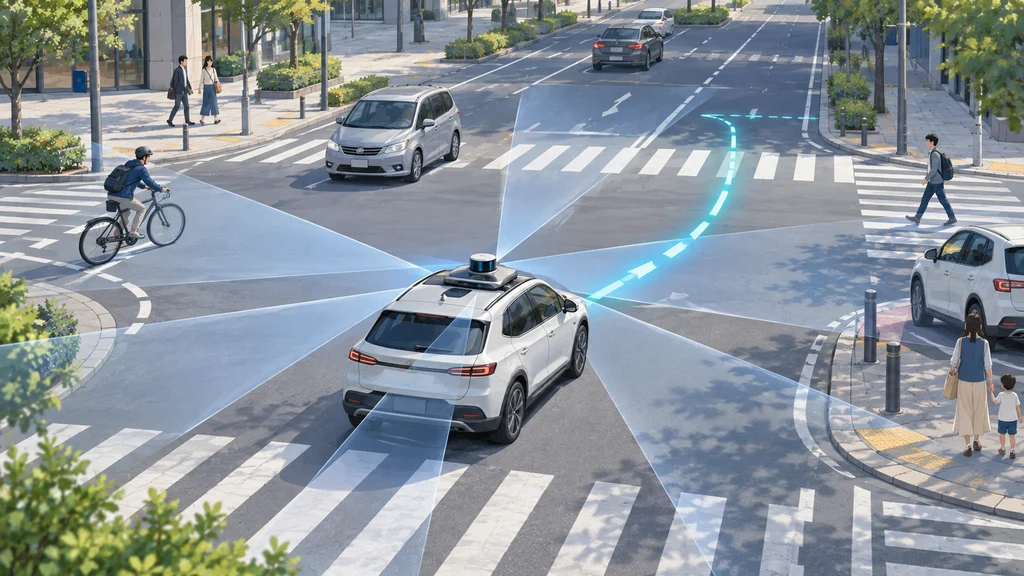
走行軌道の予測と判断理由の生成に、運転場面への回答や自動ラベル付けを加えた自動運転向けAIモデルが公開された。NVIDIAのAlpamayo 2 Superは、複数カメラから得た場面情報を共通の基盤で処理する。
場面の解釈を走行軌道の生成へつなぐ
NVIDIAが公開した自動運転車の開発向けAIモデル「Alpamayo 2 Super」は、340億パラメータで構成される。320億パラメータのCosmos 3 Super Reasonerに、拡散方式を使う20億パラメータのAction Expertを組み合わせた。
Reasonerは複数カメラの映像、言語による文脈、過去の車両の動きを解釈する。その内部表現を受け取ったAction Expertが、自車の将来の走行軌道を生成する。
周囲の映像から軌道と判断理由を併せて出力
モデルは最大7台のカメラを使い、車両の周囲360度を知覚対象にする。得られた場面情報から将来の走行軌道を生成するとともに、観測した状況と運転判断を結び付けるChain-of-Causationの推論記述も出力する。
走行軌道は自車が次に進み得る経路を示し、推論記述はその判断に関係する場面の文脈を示す。開発者は二つの出力を対応させて確認できる。
記録済み場面と閉ループシミュレーションで評価
NVIDIAが記録済みの運転場面で評価したところ、Physical AI AV Datasetの難しい1434サンプルに対する6.4秒先のminADE_6は0.911メートルだった。この指標は予測した走行軌道と記録上の軌道との距離を表し、値が小さいほど予測が近い。場面について答える能力を測るLingoQAでは79.2を記録し、評価対象の37モデル中1位だった。
記録済み場面との比較に加え、予測した行動を場面に反映する閉ループ評価も行われた。NVIDIAはAlpaSimで再構成した913場面について、スコアを1.50±0.13と報告している。
運転意図と画像上の対象を言葉に結び付ける
走行軌道とは別に、モデルは譲る、車線変更する、停止するといった高水準の運転意図をメタアクションとして出力する。経路の形に加えて、どのような運転判断を表すのかを確認できる。
運転場面について自然言語で質問すると、モデルは回答で言及した対象を画像上の2次元の枠でも示せる。回答の言葉が映像中のどの対象を指すかを対応付ける出力だ。
推論記述を映像の自動ラベルにも利用
Chain-of-Causationの推論記述は、運転映像に付ける自動ラベルとしても生成できる。走行予測で扱う場面の文脈を、データの整理に使う記述へつなげる機能だ。
自動運転車の開発では、走行軌道、運転意図、場面理解、ラベル付けに別々のモデルを使うことが多い。Alpamayo 2 Superは、これらの出力を共通のAIモデルから得る構成を採る。