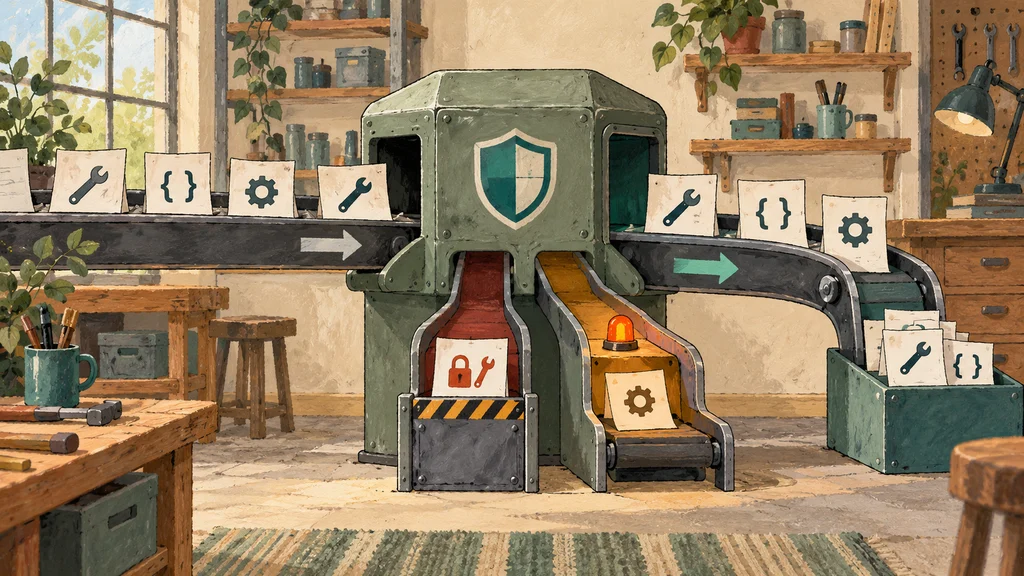
対話AIモデルClaude Fable 5の安全分類器が更新され、報告済みの特定の回避手法を99%超のケースで遮断するとAnthropicが説明した。要求や出力を検査して応答を止める仕組みを強化する一方、通常の開発作業での誤検知も増えている。
脆弱性を出力させた回避手法に分類器で対応
Anthropicによると、Amazonの研究者はClaude Fable 5の安全対策を回避し、複数のソフトウェア脆弱性を特定させた。うち1件では、その脆弱性を悪用する方法を示すコードも生成させたという。
この挙動に対応するため、Anthropicは対象の要求を遮断する改良版の安全分類器を学習させた。更新の対象は、報告された回避手法を通じて引き出された挙動である。
要求と出力を検査し、遮断時は別モデルへ送る
安全分類器は、モデルに付随して動く小規模なAIシステムである。対話中の要求やモデルの出力から潜在的に有害なサイバーセキュリティ作業を検知すると、モデルの応答を遮断する。
Anthropicによると、新しい分類器はAmazonが報告した特定の手法を99%超のケースで遮断する。この数値の対象は報告された手法であり、安全対策を回避する手法全般ではない。Fable 5への要求が遮断されると利用者に通知され、その要求は別のAIモデルOpus 4.8へ送られる。
サイバー用途を4区分し、許可と遮断を分ける
分類器は、サイバーセキュリティに関わる要求を一律に遮断する設計ではない。Anthropicは、禁止用途、高リスクの両用用途、低リスクの両用用途、無害な用途という4区分を識別するよう学習させている。両用用途は、防御にも攻撃にも利用できる作業を指す。
意図する動作では、禁止用途と高リスクの両用用途を遮断する。低リスクの両用用途は監視しながら一部を遮断し、無害な用途は一部を監視しつつ許可する。この区分は分類器に求める動作であり、個々の要求を常に正しく判定できるという意味ではない。
広い安全余裕の下で再提供、開発作業では誤検知が増加
Fable 5は、無害である可能性が高い要求の一部も予防的に遮断する「安全余裕」を、従来モデルより広く設けている。明確に安全と判断できる要求に許可を絞るため、無害な作業も遮断対象に入り得る。
Anthropicによると、今回の分類器更新では、通常のコーディングやデバッグ中に無害な要求を誤って検知する頻度が増えた。7月2日付の発表では、この安全対策を伴うFable 5の再提供が完了し、世界の利用者がアクセスできる状態になったとしている。