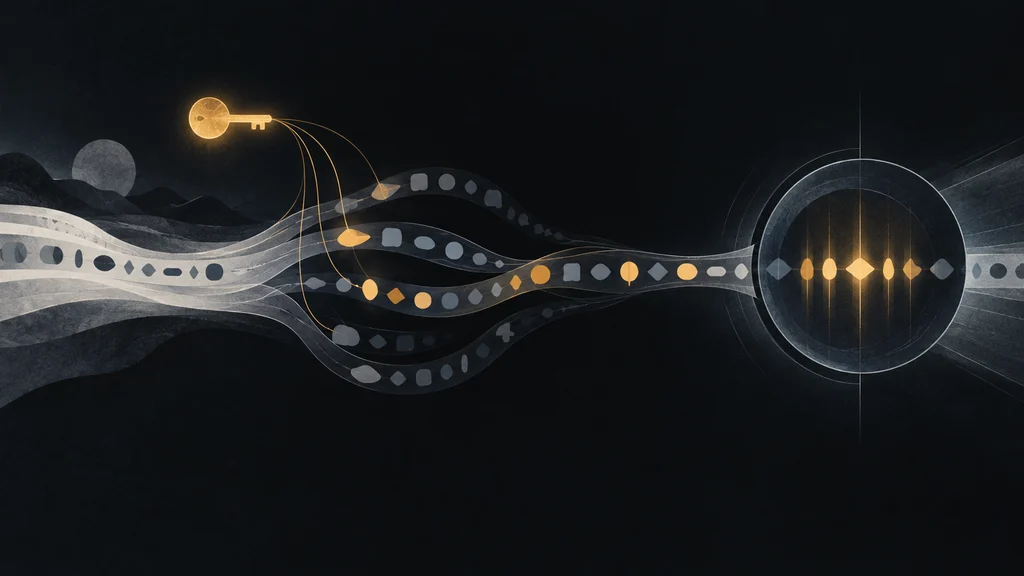
鍵と直前の文脈で語の選び方を決め、生成後の語列からAIの関与可能性を調べるテキスト透かしがClaudeの将来モデルに導入される。文字や隠し文字は加えない。
将来モデルにSynthID-Text方式を導入
Claudeの将来モデルは、テキスト透かしを含む文章を生成する設計へ移る。Anthropicは、Google DeepMindが2024年のNature論文で公表したSynthID-Textを基にした方式を採用するとしている。
この方式が判定するのは、文章がClaudeによって部分的に書かれた可能性である。鍵を持つ検証者が生成後の語列を調べ、透かしを使った場合の選択とどの程度整合するかに基づいて確率を示す。
意味を保てる語の選択にパターンを残す
大規模言語モデルは、直前までの文章に応じて次の語の候補を絞り、その中から一つを選ぶ。意味や自然さがほぼ変わらない候補が複数ある場面では、どれを選んでも読者が受け取る内容への影響は小さい。
テキスト透かしは、こうした選択を文章中で繰り返し、鍵で検出できるパターンを語列に残す。通常なら任意の乱数発生器から得るランダム性を、鍵と直前の数語から決めることで、生成後にも選択の整合性を検査できるようにする。
選択そのものは引き続きランダムであり、モデルが通常は候補にしない不自然な語を選ばせる処理ではない。正確さや意味を損なわずに候補を選べる箇所が、透かしを残す場所になる。
文字や識別情報を加えず品質を維持
検出用のパターンは語の選び方に生じるため、文章へ可視の記号や隠し文字を挿入しない。追加トークンも必要とせず、透かしには人物、組織、個別のチャットへ結び付く識別情報も含まれない。
Anthropicは、読者が透かし付きと透かしなしの応答を区別することはできないとしている。内部テストでは、文章の内容、創造性、可読性への影響は確認されなかった。
文章の長さと語の選択幅が検出を左右
鍵との整合性が示すのは、Claudeが文章の一部に関与した可能性に限られる。検出結果から人間が書いたと確認することはできず、異なる鍵や方式を使う別のAIによる生成を判定することもできない。
短い文章では、透かしを残せる語の選択回数が少なく、判定に使える情報も減る。文章が長くなり、選択が積み重なるほど、Claudeの関与を判断する信頼度は高くなる。
事実記述のように正しい語が限られる箇所では、正確さを保ったまま選択を変えにくいため、透かしは疎になる。人が書いた文章の文法や句読点を軽く直す校正でも、Claudeが選び直す語が少なければ、関与を検出できるだけのパターンが残らないことがある。