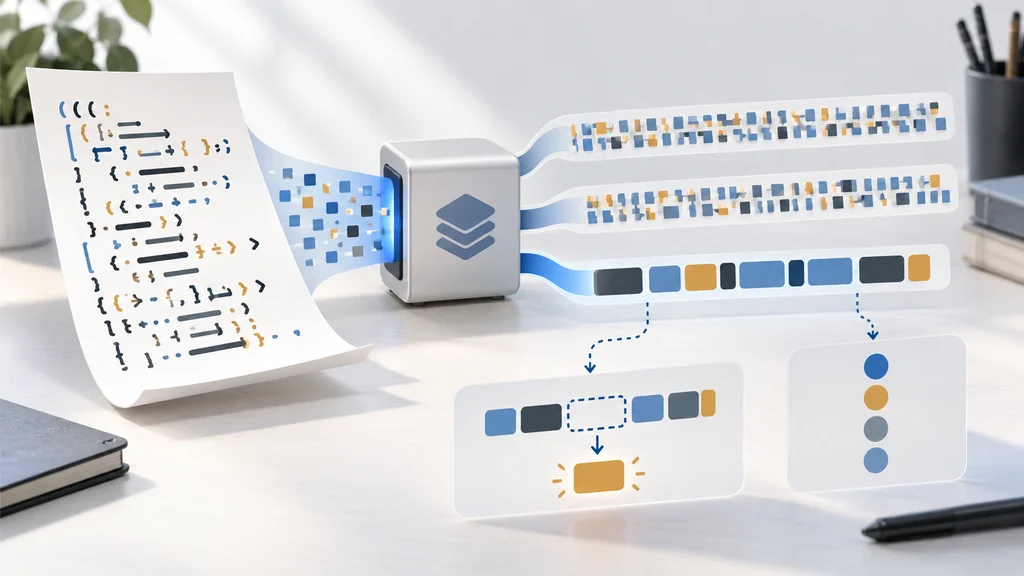
コードで学習したAIモデルCodeBERTaは、入力の分割器もコードに合わせた。Hugging Faceによると、同じコードから作るトークン列は、GPT-2やRoBERTaの分割器を使う場合より33~50%短い。
約200万の関数からコード向けモデルを学習
Hugging Faceのコード向けモデルCodeBERTa-small-v1は、CodeSearchNetのコードを使って学習したRoBERTa型モデルだ。6層、8400万パラメータで構成される。
学習には約200万の関数を含むコーパスを使い、モデルを初期状態から5エポック学習した。コードを入力として扱うこの構成では、入力をどうトークンに分割するかもモデルの設計に含まれる。
コードで学習した分割器がトークン列を短縮
CodeBERTaのByte-level BPEトークナイザーは、コードのコーパスで学習した。入力されたコードは、この分割器によってモデルが処理するトークン列になる。
Hugging Faceによると、同じコードのコーパスを分割したとき、トークン列はGPT-2やRoBERTaのトークナイザーを使う場合より33~50%短い。この比較は入力表現の長さを示すもので、コードの補完精度を比較した数値ではない。
隠したコードを予測するモデルとして利用
CodeBERTa-small-v1は、コード中の一部を隠して予測するFill-Maskモデルとして利用できる。分割された入力を受け取り、隠した位置に入る候補を返す。
モデルカードに掲載されたPHPコードの例では、予測候補の最上位は「function」だった。この結果は掲載例に対する出力であり、補完全般の正解率を示す測定値ではない。
分類ヘッドを加えてプログラミング言語を識別
コード向けの事前学習結果は、別の処理にも使われた。プログラミング言語識別モデルCodeBERTa-language-idは、CodeBERTa-small-v1のチェックポイントに系列分類ヘッドを追加し、識別向けにファインチューニングしたものだ。
Hugging Faceによると、この識別モデルは評価データで正解率とF1がともに0.999を超えた。コードの隠した部分を予測する事前学習モデルから、コード全体の言語を分類するモデルへ処理対象が広がった。