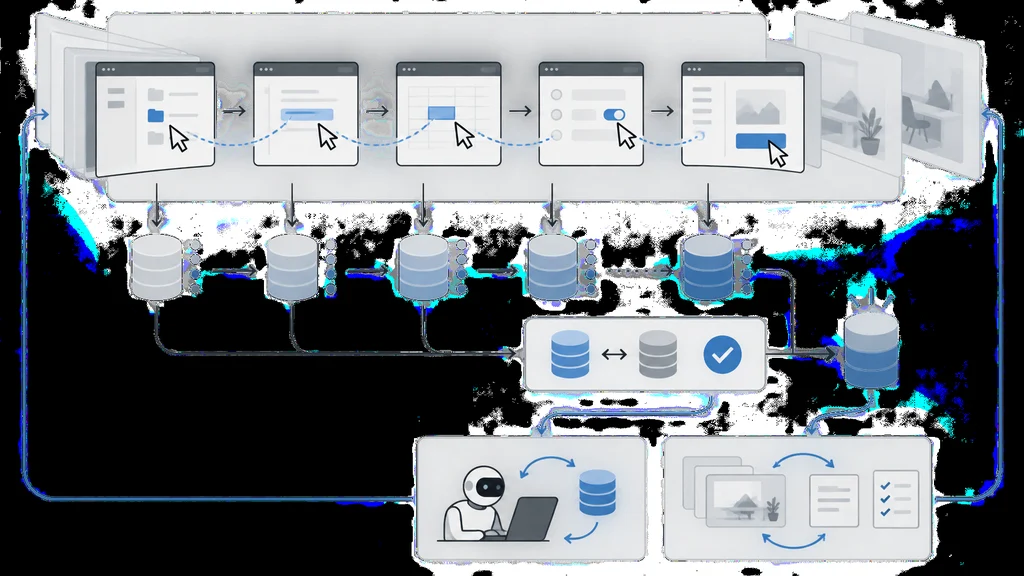
操作結果を内部状態から採点する12種類の合成環境で訓練した9Bモデルは、Microsoftの測定でスコアを36.5%から67.1%へ伸ばした。失敗はモデルと訓練環境の双方の改善に使われる。
操作後の内部状態を正解と照合する
コンピューター操作エージェントが行動の結果を学ぶには、クリックで保存状態が変わったか、送信したメッセージが受信者へ届いたかといった帰結が必要になる。Microsoftは、スクリーンショットだけでは画面の背後にある状態変化を捉えられず、実際のサービスを反復訓練に使えば実在するアカウントやデータを書き換えてしまうと説明している。
この問題に対し、合成環境はアプリケーション、その状態と状態を変える操作、目標を与えるタスク、結果を正解状態と照合する検証器を一体化する。管理可能なデータベース上で実際に状態を変えつつ、データと条件を固定して課題を繰り返せるため、画面の外観ではなく操作後の状態を訓練信号にできる。
深い環境が多段階操作の因果関係を保つ
訓練環境の深さはページ数ではなく、業務の因果構造をどこまで再現するかで決まる。深い環境では、操作部品、権限、エラーが製品の論理に従い、送信したメッセージが受信者側にも現れるなど、画面や利用者をまたぐ状態が整合する。
整合した状態は多段階のワークフローへ引き継がれ、前の選択が後続操作の条件を変える。成否もピクセルではなくアプリケーション内部の状態から判定される。Microsoftが同じサイトの浅い環境と深い環境で訓練効果を比べたところ、浅い環境ではモデル性能が低下した一方、深い環境では向上した。
二種類の環境を検証可能な仕様から生成する
Microsoftが構築した合成環境生成パイプラインのEchoverseは、二種類の訓練環境を出力する。ドメイン環境はアプリケーションのワークフローを深く再現し、能力環境はモデルが苦手とする一つの操作を異なる表示形式で反復させる。
構築工程では、少数のシードシナリオを仕様へ展開し、ルート、状態、挙動に関する機械検証可能な主張へ変換する。その後、FastAPIとSQLiteによるバックエンドとReactによるインターフェースを生成する。
生成直後のアプリケーションは仮説として扱い、各主張を稼働環境に照合する。検証に通らない箇所があればデータベース、バックエンド、フロントエンドを修正し、すべての主張が通った後に、重大な阻害要因と助言上のリスクを区別した準備記録を作る。
一度の採点結果をモデルと環境の双方へ戻す
検証済みの環境でモデルを動かすと、一度の採点結果が二つの更新経路へ送られる。残った失敗はモデルの訓練データとなり、環境、タスク、検証器に見つかった欠陥はそれぞれの修正材料になる。修正した環境で評価と学習を繰り返すため、更新対象はモデルだけに限られない。
能力環境では、日付選択や入れ子のフィルターのようにモデルが苦手とする操作を、異なる画面構成で訓練する。Microsoftによると、この訓練を受けたモデルは、訓練時に見ていない領域でも同種の操作を扱えるようになったという。
内部状態を報酬にして性能と操作手順を改善する
正解状態に基づく検証器は、強化学習の報酬にも使われる。目標へ到達したかをアプリケーション内部のデータから判定することで、見た目の一致ではなく、操作が生んだ結果を学習へ返す。Microsoftの実験では、この報酬によって訓練に使わなかった評価対象での性能が向上し、モデルはより少ない手順で目標へ到達する動作を学習した。
Echoverseは、深いドメイン環境10種類と、日付選択および入れ子のフィルターを扱う能力環境2種類を用意した。Microsoftの測定では、12種類すべてで訓練した9Bモデルのスコアは36.5%から67.1%へ上昇し、GPT-5.4との差は14ポイント以内になった。