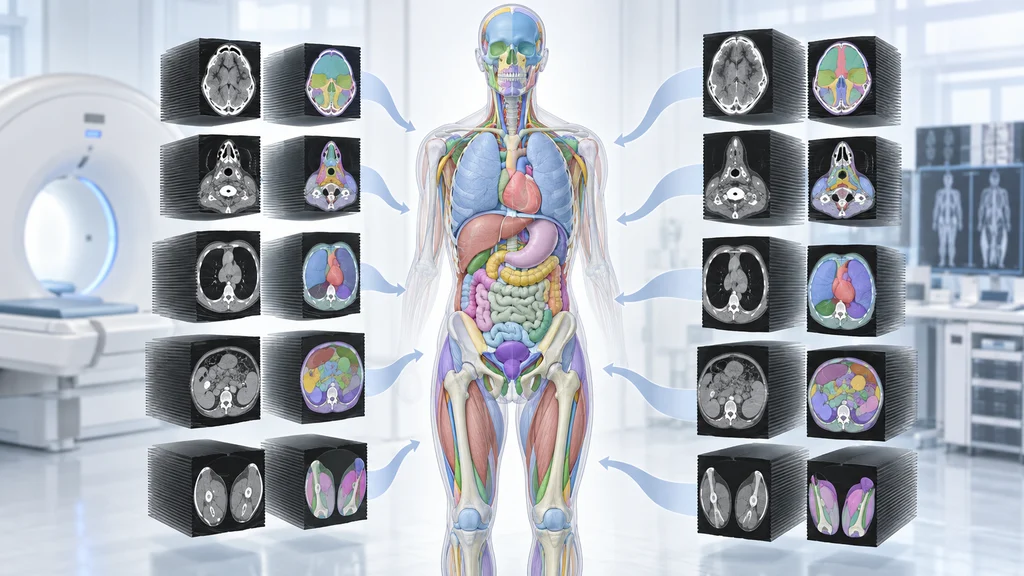
頭部から膝までの167種の解剖構造を、2万2022件のCTの3次元画像で注釈したCADS-datasetが公開されている。擬似ラベル付けと教師なしの品質管理を組み合わせ、広い範囲のCT画像を一つのデータセットにまとめた。
2万2022件のCTで頭部から膝までを扱う
CADS-datasetには2万2022件のCTボリュームが収録され、各画像に167種の解剖構造の注釈が付いている。対象は頭部から膝までに及び、複数の解剖領域を同じデータセットで扱う。
複数の収集元を自動処理で注釈する
画像の収集元には、16カ国の100以上の撮像施設に由来する公開データと病院データが含まれる。CADSの構築には、画像へ暫定的な注釈を与える擬似ラベル付けと、教師なしの品質管理を組み合わせた自動処理が使われた。
元の画素間隔を保って画像とマスクを提供
元のCT画像と、構造ごとの位置を示すセグメンテーションマスクは、画素間隔を保ったNIfTI形式で提供される。Hugging Faceで公開されているCADS-datasetの説明では、既存のコレクションとの比較でCT件数は18倍、対象構造の種類は60%多いとされている。
注釈データを使う自動セグメンテーションモデル
CADS-modelは、全身CTの自動セグメンテーションに使うモデル群として提供される。公開ページには、公開チャレンジと病院の患者集団で性能を検証したと記載されている。
モデルはPythonスクリプトからコマンドラインで実行でき、医用画像ソフトウェアの3D Slicer向けプラグインからも操作できる。画像と注釈に加え、セグメンテーションを実行する手段まで公開されている。