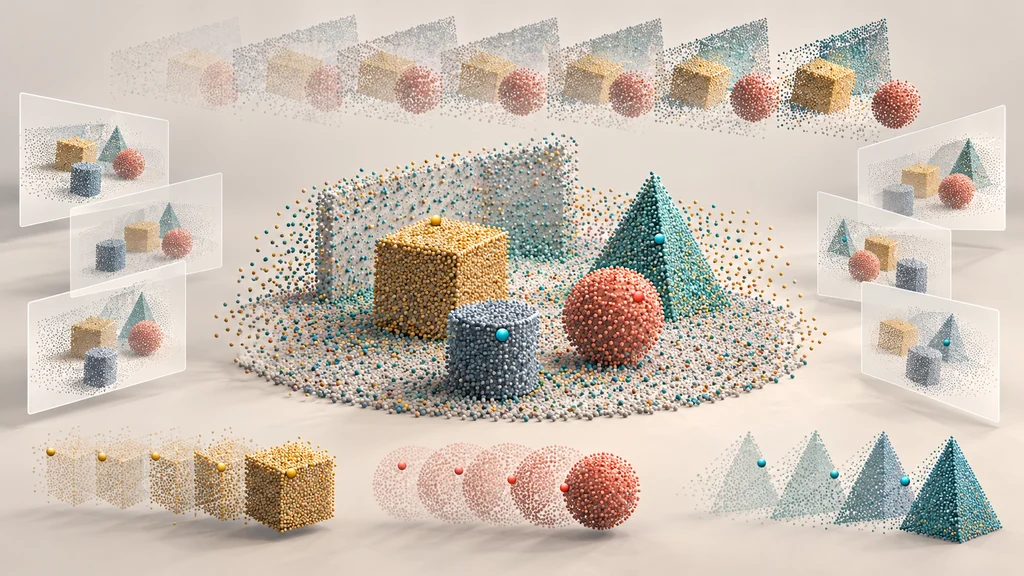
動画に映る立体形状と、その時間変化を一つのAIモデルで復元するD4RTが登場した。画素の3次元位置を時刻と視点を変えて問い合わせることで、点の追跡、点群の生成、カメラの軌跡推定を共通の仕組みで処理する。
形状の復元と動きの追跡を一つのモデルへ
Google DeepMindが開発した動画解析AIのD4RTは、動的な場面の復元と追跡を一つのモデルへ統合した。対象は、3次元の空間に時間を加えた4次元の場面である。
Google DeepMindは、従来の復元には計算負荷の大きい処理や、深度、動き、カメラ角度などに特化した複数モデルの組み合わせが必要だったと説明している。D4RTはこれらを共通の問い合わせで処理する構成を採った。
動画の圧縮表現から必要な位置を取り出す
モデルはエンコーダー・デコーダー型のTransformerで構成される。エンコーダーが入力動画を処理し、場面の形状と動きをまとめた圧縮表現を作る。
軽量なデコーダーはその表現を受け取り、動画中の指定画素が、指定時刻に、選んだカメラ視点でどの3次元位置にあるかを求める。それぞれの問い合わせは独立しており、並列に処理できる。
時刻と視点の指定で追跡・点群・カメラ推定を切り替える
Google DeepMindによると、時刻を変えながら同じ画素の位置を問い合わせれば、対象の3次元軌跡を予測できる。別のフレームで対象が見えていない場合も、位置の予測が可能だという。
時刻とカメラ視点を固定すると、出力は場面の立体形状を表す点群になる。この生成では、別途のカメラ推定や動画ごとの反復最適化が不要になるとしている。
さらに、同じ瞬間の3次元構造を異なる視点から生成し、それらを位置合わせするとカメラの軌跡を推定できる。問い合わせる時刻と視点の組み合わせによって、対象の移動と撮影側の移動を扱う処理を切り替える。
単一TPUで1分間の動画を約5秒で処理
Google DeepMindの試験では、D4RTは従来の最先端手法に対して18~300倍の処理速度を示した。この範囲は評価された処理の比較結果であり、すべての動画に一律に適用する速度倍率ではない。
具体的な処理例では、単一のTPUチップで1分間の動画を約5秒で処理した。入力動画の長さを大きく下回る時間で処理を終えた例となる。