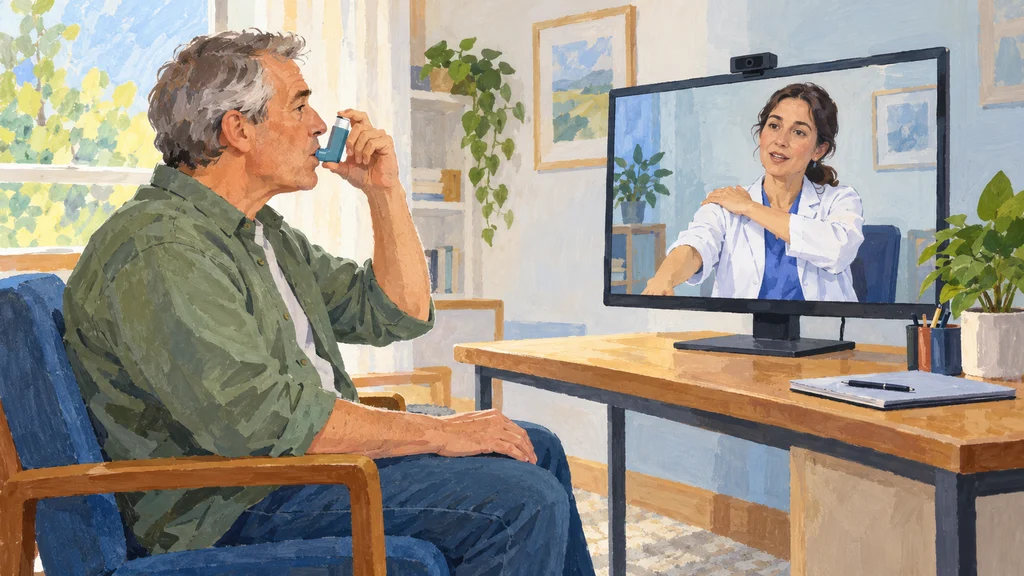
医療AIが、映像・音声で患者役と対話し、吸入器の使い方の修正や肩の診察動作の誘導を行った。Google DeepMindの模擬遠隔診療で示された能力で、診療技能の一部は医師と同等以上だった一方、総合評価では医師が上回った。
テキストの相談から映像・音声の対話へ
Google DeepMindが研究する医療AI「AI co-clinician」は、AIモデルのGeminiと、リアルタイムの視聴覚対話を扱う研究プロジェクトProject Astraの能力を基盤とする。模擬遠隔診療では、リアルタイムの映像・音声を使って患者役と対話する能力を試験した。
先行する医療対話AIのAMIEは、テキストによる模擬診療で評価されていた。今回の試験は、文字でのやり取りから、患者役の動作を伴う診療対話へ評価対象を広げている。
20の架空症例を医師が演じる
映像・音声を使う対話の評価に向け、Google DeepMindはハーバード大学とスタンフォード大学の医師と協力し、無作為化シミュレーション試験を設計した。20の架空の臨床シナリオを用意し、10人の医師が患者役を務めた。評価対象は実患者への診療ではなく、条件を設定した模擬診療での応答と行動である。
吸入器の使い方を修正し、肩の動作を誘導
Google DeepMindによると、AIは模擬診療で患者役の吸入器の使い方を修正することに成功した。患者役との対話を通じ、器具を使う手順への介入まで行った例に当たる。
身体診察では、腱板損傷を特定するための肩の動作も誘導した。テキストで症状を聞き取るだけだった評価範囲に、患者役がその場で行う動作の案内が加わった。
68項目で医師と同等以上、総合評価では及ばず
Google DeepMindの模擬診療評価では、AI co-clinicianは診療技能の140評価項目のうち68項目で、プライマリケア医と同等以上の成績を示した。この数値は技能を項目別に比較した結果であり、診療全体の成功率を表すものではない。
総合評価では医師がAIを上回った。特に、危険な兆候を識別する能力と、重要な身体診察を誘導する能力で医師が優れていた。