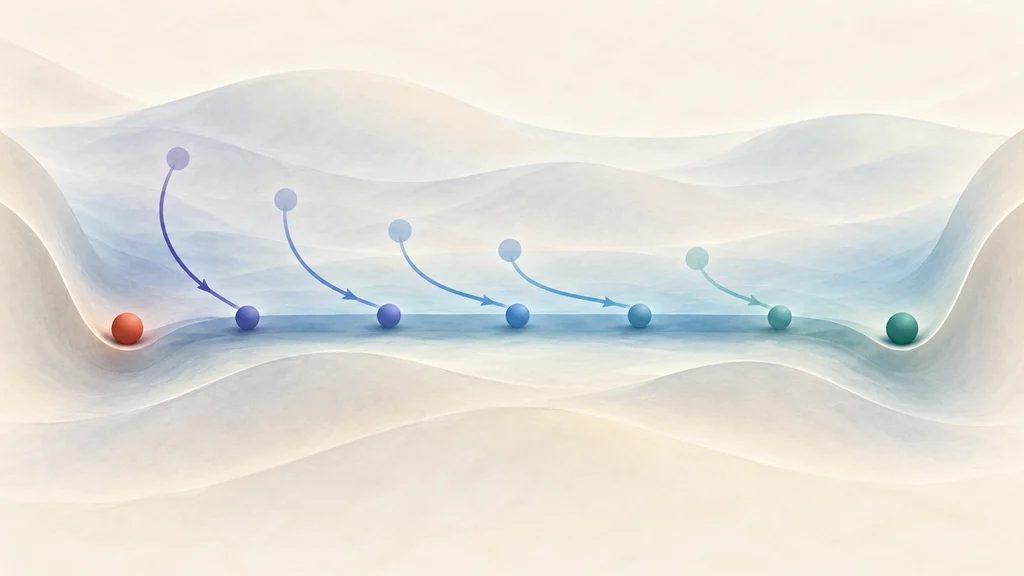
拡散モデルが訓練データを複製せず、新しいデータを生む仕組みが、学習時のスコア関数の平滑化から説明された。Googleは、ノイズ除去中のデータ点が訓練点の間にとどまる補間効果を数学的に定量化し、学習実験でも平滑化を確認した。
ノイズ除去の行き先を決めるスコア関数
拡散モデルでは、スコア関数がノイズ除去中のデータ点の移動方向を定める。訓練データから学んだこの関数に従ってデータ点が移動し、ノイズから意味のあるデータへ近づいていく。
Googleは、その移動を導く関数の滑らかさに着目した。ニューラルネットワークの正則化に関する関数空間の理論とノイズ除去の数学を組み合わせ、スコア関数の平滑化が訓練データ間の補間を生む関係を定量化した。
2つの訓練点への収束が補間へ変わる
訓練データを−1と+1の2点だけにした一次元の例では、完全なスコア関数は、ノイズ除去の終盤に中央付近で符号を急激に変える。中央より左のデータ点は−1へ、右のデータ点は+1へ引かれ、最終的にいずれかの訓練点へ収束する。
スコア関数を滑らかにすると、この中央付近の流れが変わる。訓練点の間にあるデータ点の移動が遅くなり、2点の間の補間領域にとどまるため、訓練点と一致しないデータが生まれる。
正則化の強さが学習済み関数の形を変える
Googleの実験では、2層のReLUニューラルネットワークに一次元のスコア関数を学習させた。最適化アルゴリズムにはAdamWを使い、正則化の一種であるweight decayの強さを変えて、学習後の関数の形を比較した。
weight decayが強いほど、訓練点の間でスコア関数が滑らかになった。この平滑化は明示的な正則化だけに依存せず、weight decayなどを使わない実験でも、勾配に基づく学習の暗黙的な正則化から生じた。
多次元では移動方向ごとに平滑化の効果が異なる
画像のような高次元データでは、意味のあるデータが分布する領域をデータ多様体と呼ぶ。画像生成は、有限の訓練データからその未知の形状と位置を推定し、多様体上に新しい点を生成する課題として捉えられる。
多次元の解析では、スコア関数の平滑化は、多様体に沿う方向の移動を一次元の例と同様に遅くする。一方、多様体へ向かう方向では元のスコア関数が比較的滑らかで、追加の平滑化による影響は小さい。多様体が平らな場合、この方向のスコア関数は直線になる。