AIエージェントの実行側が知る要求の優先度や出力長を、推論基盤の判断に渡せるようになった。NVIDIAは推論基盤Dynamoにagent_hints拡張を導入し、ルーティングとスケジューリングへ接続した。
繰り返す会話の接頭部分を推論基盤へ渡す
AIエージェントの連続した推論要求では、システムプロンプトと、それまでの会話の接頭部分が繰り返し使われる。この部分の計算結果をKVキャッシュから再利用できるかどうかが、要求の割り当てに関わる。
NVIDIAの推論基盤Dynamoは、v1/chat/completions、v1/responses、v1/messagesの3種のエンドポイントを共通の内部表現で扱う。後の2種では思考、ツール呼び出し、テキストを型付きのコンテンツブロックとして区別でき、推論基盤もその境界を読み取れる。
agent_hintsが要求の優先度と出力長を伝える
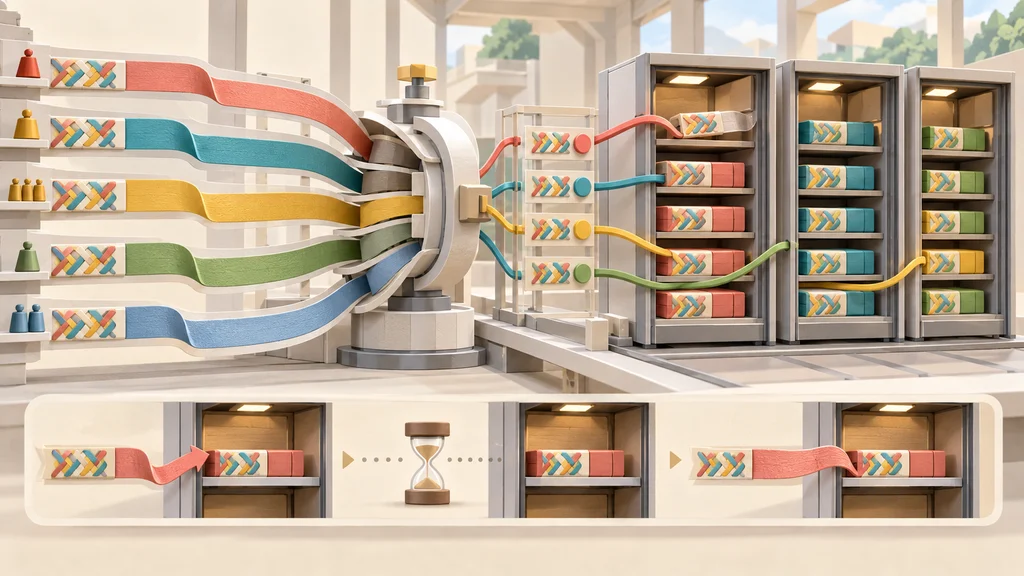
Dynamoの新しいagent_hints拡張は、3種のエンドポイントから送る要求に構造化されたヒントを付ける。エージェントを動かす側が持つ情報を推論基盤へ渡し、ルーターと推論エンジンの判断に使う仕組みだ。
priorityはルーターの待ち行列での順序と、推論エンジン側の優先度に使われる。oslには生成するトークン数の見積もりを入れ、ルーターがワーカーの占有時間を判断する材料とする。
要求の到着前とツール待機中に接頭部分を扱う
speculative_prefillは、推論要求全体が用意される前に、見込みのあるワーカーで接頭部分のキャッシュを始めるよう伝える。たとえばツール呼び出しの返答を待つ実行側は、次の要求に備える意図を推論基盤へ知らせられる。
計算済みの接頭部分には、cache_controlで保持期間を指定できる。指定した期間はワーカー上の接頭部分をキャッシュから追い出さないため、ツール処理による要求間の空白も保持方針に反映できる。
Flash IndexerがKVキャッシュの一致範囲を探す
ルーターがキャッシュの所在を判断する材料は、Flash Indexerが管理する索引から得る。索引は、どのワーカーがKVブロックを保持しているかを追い、要求の接頭部分がどこまで一致するかをワーカーごとに返す。
索引には、ブロックの保存時と削除時に、各推論エンジンに付随する発行側から更新イベントが届く。NVIDIAによると、Flash Indexerはこうした更新と検索を含む索引操作を1秒あたり1億回超処理する。