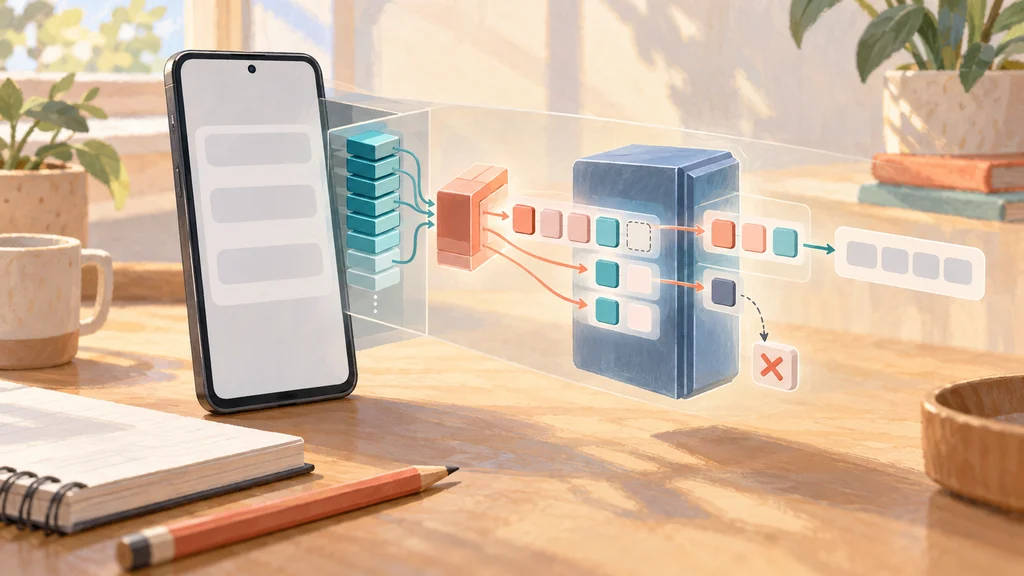
端末内AIモデルの重みを変えず、予測用の小型層だけを追加して文章生成を高速化する方式がPixel 9・10へ展開された。Gemini Nano v3が計算した内部状態を候補生成に再利用し、本体の出力を保ちながら複数のトークンをまとめて検証する。
学習済みの本体に予測用の層を後付けする
Googleは、端末内AIモデルのGemini Nano v3に、複数のトークンを先読みするMulti-Token Prediction(MTP)を後付けした。この方式はPixel 9・10シリーズへ展開済みで、本体の重みを固定したまま、追加したMTPヘッドだけを学習する。
MTPヘッドは、本体の最終層付近に接続する軽量なTransformerである。本体が計算した隠れ状態を受け取り、それを使って将来のトークンを順番に予測することで、検証に渡す候補列を作る。
候補をまとめて検証し、本体の出力を保つ
予測用の層が作った候補列は、本体モデルによる並列検証へ進む。本体の予測と一致した候補を採用し、不一致があれば最初に食い違った位置から先を採用しない。
Googleは、この検証で不正確な候補を破棄するため、最終出力が本体モデルとビット単位で同一に保たれるとしている。先読みした候補をそのまま出力するのではなく、本体による確認を通った部分だけを生成結果へ組み込む。
KVキャッシュを共有し、入力処理の重複を省く
候補生成でもう一つの履歴を保持すると、端末内で使うメモリーが増える。MTPヘッドは独自の履歴を持つ代わりに、本体が計算済みの情報を保持するKVキャッシュを直接参照する。
Googleによると、この再利用によって、候補生成側がプロンプトを読み込むprefillという初期処理の追加時間をなくした。候補生成側の埋め込み参照表なども省くことで、独立した候補生成モデルに比べ、実行時メモリーを1インスタンス当たり最大130MB削減したとしている。
通知要約と文章校正で追加トークンを予測
GoogleはPixel 9・10への展開に合わせ、端末内の推論スタックも再設計した。候補を作る段階と検証する段階の依存関係を処理し、この予測方式を実際の端末内処理へ組み込んだ。
Googleの本番ワークロードでの結果では、通知要約機能のAI Notification Summariesや文章校正機能のProofreadで、推論1回当たり平均約2個の追加トークンを正しく予測した。本体が検証する候補列に、実際に採用できる先読みトークンが含まれることを示す結果となっている。