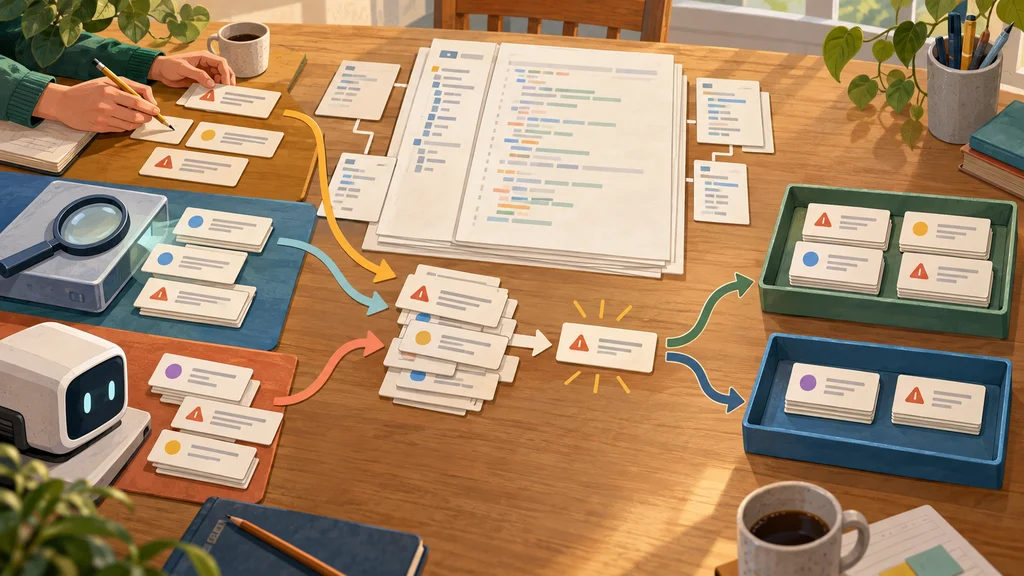
AIコードレビューが見つけた問題を、用意された正解との一致だけでなく、新しい有効な指摘としても採点する。GitHubが公開した評価基盤ReviewBenchは、既知の問題をどれだけ捉えたかと、正解集合の外で何を見つけたかを分けて評価する。
19言語の変更を共通条件でレビューする
GitHubは、AIコードレビューの評価基盤ReviewBenchを公開した。評価対象には、187の公開オープンソースリポジトリから集めた19言語・219件のプルリクエストを使い、共通の採点方式でレビューを比較する。
評価対象の構成には、1億390万件のプルリクエストを分析した分布を反映した。言語とリポジトリ規模はGitHub全体に近づける一方、変更規模は極小の単一ファイル変更への偏りを抑え、より実質的な複数ファイルの変更を残している。
複数の情報源から正解指摘を集める
各プルリクエストの正解指摘は、人間のレビューだけから作るわけではない。候補には、作成者の後続コミットから推定した問題、決定的な解析ツールの検出結果、複数系列の大規模言語モデルによる指摘も加える。
集めた候補のうち、同じ根本的な問題を指すものは意味に基づいて統合する。複数の情報源が同じ問題を見つけても重複して数えず、異なる問題を正解集合へ取り込む構成になっている。
指摘元によらず三つの条件で妥当性を判定する
統合した指摘は、採点用の言語モデルClaude Sonnet 5が共通基準で判定する。正しいこと、対象の変更に関連すること、些末でないことを満たす指摘を有効とし、人間やモデルといった指摘元によって基準を変えない。
GitHubは、正解指摘を熟練エンジニアが確認した際の一致率を96.6%と公表した。この数値は正解指摘の判定に関する一致率であり、評価されるAIの問題検出率を示すものではない。
既知の正解との一致と新しい発見を分けて測る
採点では、既存の正解ラベルだけを使うGrounded指標で適合率、再現率、F1スコアを計算する。適合率は出した指摘のうち正解に一致する割合、再現率は既知の正解のうち見つけた割合を表し、F1スコアは両者を等しく重視する。
正解集合に一致しない指摘は、Augmented指標で別途判定する。採点用モデルが有効と認めた新しい指摘も評価へ反映するため、正解集合を作った段階で見つからなかった問題を捉えたレビューにも評価を与えることができる。