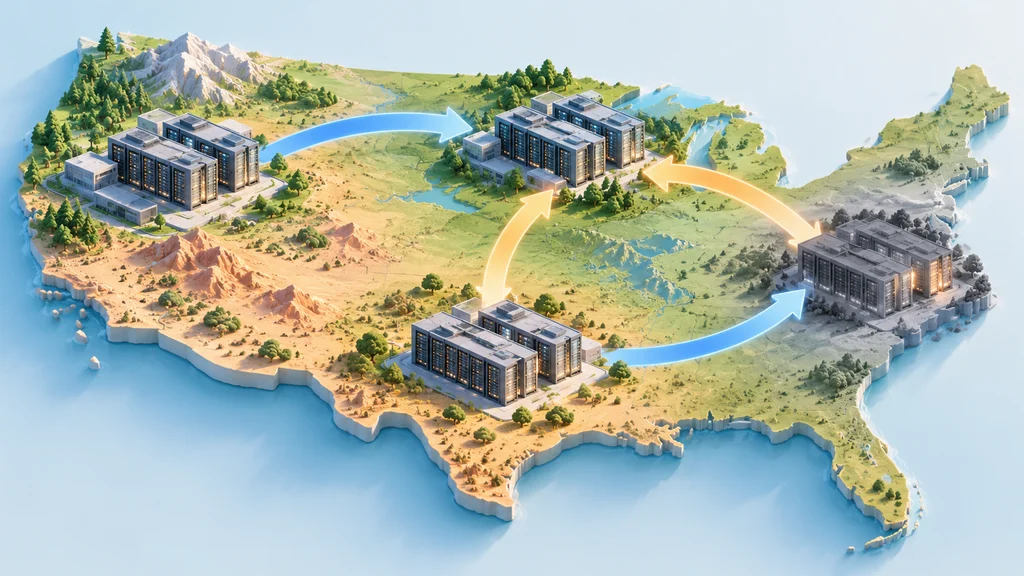
離れた計算拠点を非同期につなぐ学習方式で、120億パラメーターのAIモデルを米国4地域に分散して学習した。Googleが開発したDecoupled DiLoCoは、計算群ごとに障害の影響を切り分け、停止した計算群を復帰後に学習へ戻す。
計算群を非同期につなぎ、通信を計算に重ねる
Google DeepMindとGoogle Researchが開発した分散学習方式Decoupled DiLoCoは、分散システムPathways上で動く。learner unitsと呼ぶ計算群を分け、その間を非同期のデータフローで接続する。
Googleは、従来の大規模AI学習では同一種のチップを緊密に同期させる必要があると説明している。新方式は必要な通信を長い計算期間に重ねることで、他の計算部分を待つことによる処理の停滞を避ける。
計算群の停止と復帰を学習全体から切り分ける
Googleは、人工的にハードウェア障害を起こす試験で、この分離が学習の継続にどう働くかを確かめた。計算群全体が失われても学習は続き、停止した計算群がオンラインに戻ると、学習へ再統合された。
言語モデルGemma 4を使った試験では、障害発生時の学習クラスタの可用性が従来方式より高かった。モデルのベンチマーク性能も従来の学習方式と同等で、障害への対処と学習後の性能を両立したとしている。
2〜5 Gbpsの広域網で米国4地域を接続
Googleは、この方式を用いて120億パラメーターのモデルを米国の4地域に分散させて学習した。拠点間に用いた広域網の帯域は2〜5 Gbpsだった。
この4地域での実験について、Googleは従来の同期方式より20倍超速く学習できたとしている。速度の比較対象はモデルの推論ではなく、離れた拠点を結ぶ条件での学習である。
異世代チップの混在でもモデル性能を維持
非同期に接続する構成は、学習に使うハードウェアの組み合わせも広げる。Googleによると、AI計算用チップのTPU v6eとTPU v5pのように、異なる世代のハードウェアを一つの学習に混在させることができる。
Googleの実験では、異なる速度で動く複数世代のチップを組み合わせた。混在構成で学習したモデルは、単一種のチップによる学習と同等の性能を得た。