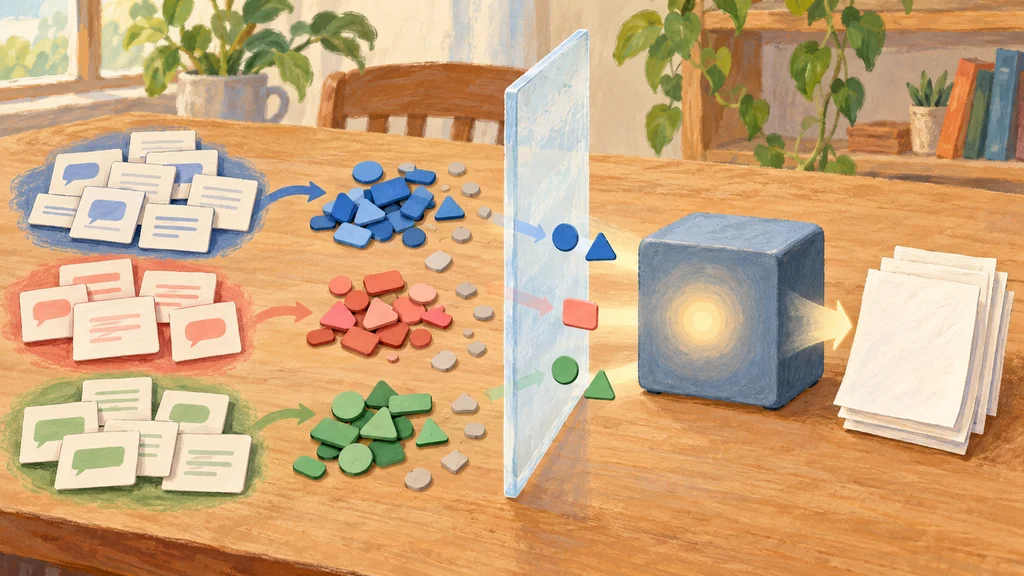
AIチャットの利用傾向を調べる処理に、個々の会話が出力へ及ぼす影響を数学的に制限する差分プライバシーが組み込まれた。会話の分類とキーワード抽出を保護し、最終要約を担うLLMには元の会話を渡さない。
会話を分類し、キーワードの集計へノイズを加える
Googleが開発した分析手法Uraniaは、差分プライバシー(DP)を備えたクラスタリングとキーワード抽出を、LLMによる要約へつなぐ。まず会話を数値表現へ変換し、近いものをクラスタにまとめる。この分類段階で、個々の会話がクラスタの中心へ及ぼす影響を抑える。
次に、各クラスタでキーワードの出現回数をヒストグラムとして集計する。その集計値へノイズを加えてキーワードを選ぶことで、個々の会話の影響を保護しながら、複数の会話に共通する話題を取り出す。
要約用LLMの入力を会話から保護済みの語へ替える
選ばれたキーワードは、クラスタごとの要約を生成するLLMへ渡される。この最終段階のLLMは元の会話を受け取らない。差分プライバシーで保護した出力を後処理しても保証が維持される性質により、要約までを保護の対象にする。
Googleが比較用に作成したSimple-CLIOは、差分プライバシーを使わずに会話を分類し、クラスタから抽出した会話そのものをLLMへ渡す。新方式では、この入力を保護済みのキーワードへ置き換え、要約生成を会話原文から切り離した。
保護を強めると話題は絞られるが、要約は最大70%で選好
Googleの評価では、保護の強さを調整するプライバシー予算εを小さくすると、クラスタの数と精度が低下した。それに伴い、要約が扱う話題の範囲も狭くなり、保護の強さと分析の細かさの間にトレードオフが生じた。
一方、LLMを評価者とする要約の比較では、差分プライバシーを使った側が選ばれる場合も多かった。評価の一つでは、Simple-CLIOより選好される割合が最大70%に達した。これはLLMによる選好評価の結果であり、利用者による評価とは区別される。
会話の包含を探る攻撃ではAUCが0.53
要約の品質に加え、Googleは特定の機微な会話がデータセットに含まれていたかを推測する攻撃を試した。個別の会話の存在を、処理の出力から見分けられるかを調べる評価である。
攻撃の識別性能を表すROC曲線下面積(AUC)は、差分プライバシーを使った処理で0.53、使わない処理で0.58だった。保護した処理では、攻撃の性能がランダムな推測に近い値となった。