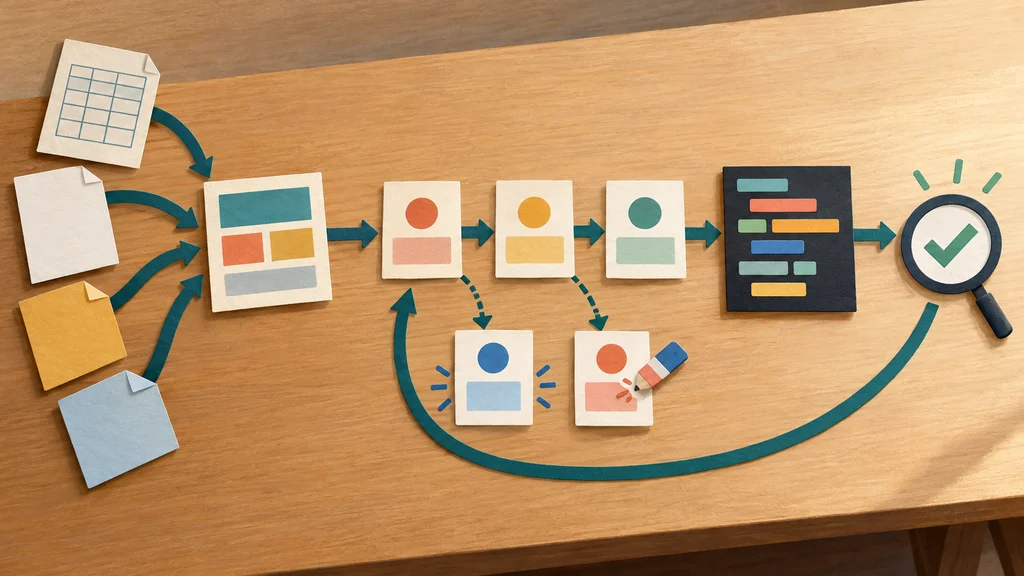
データ分析AIのDS-STARは、異なる形式のファイルを要約して分析計画を立て、LLMの判定に応じて手順を追加・修正する。Googleの評価では、データ分析向けの3つのベンチマークで比較対象の最良値を上回った。
ファイルの構造と内容を計画の入力にする
Googleが開発したデータ分析AIエージェントのDS-STARは、非構造化データを含む異なる形式のファイルを分析に取り込む。処理の最初にディレクトリ内の全ファイルを調べ、それぞれの構造と内容をテキストに要約する。
この要約が、課題を解くための文脈となる。計画を担当するPlannerは、その情報を使って高水準の分析手順を組み立て、コード生成を担当するCoderが実行するコードへ変換する。
LLMの判定から手順の追加と修正へ進む
コードへ変換した計画は、検証を担当するVerifierが評価する。LLMを判定役として使い、現在の計画で課題を十分に解けるかを調べる。
不十分という判定を受けると、更新方法を選ぶRouterが、手順を追加するか既存の手順を修正するかを決める。更新後は再び計画、コード化、検証を進め、計画が十分と判定されるか、反復が上限の10回に達した段階で最終コードを出力する。
3つの分析ベンチマークで比較対象を上回る
Googleの評価では、データ分析向けベンチマークのDABStepで正答率が45.2%となり、比較対象の最良値41.0%を上回った。計画の生成から検証・更新までを組み込んだ構成全体としての結果だ。
別の分析ベンチマークでも、KramaBenchでは比較対象の最良値39.8%に対して44.7%、DA-Codeでは37.0%に対して38.5%となった。3つの評価で、既存方式との正答率の差が確認された。
ファイルの説明と手順修正を外すと正答率が低下
Googleは、構成要素を取り除く実験でも処理の役割を調べた。ファイル解析で生成する説明を使わない構成では、DABStepの難しい課題で正答率が26.98%となり、通常構成から低下した。
Routerを外すと、計画の更新は手順を順次追加するだけになる。この構成も、DABStepの容易な課題と難しい課題の両方で通常構成を下回り、追加と修正を選び分ける構成の方が高い性能を示した。