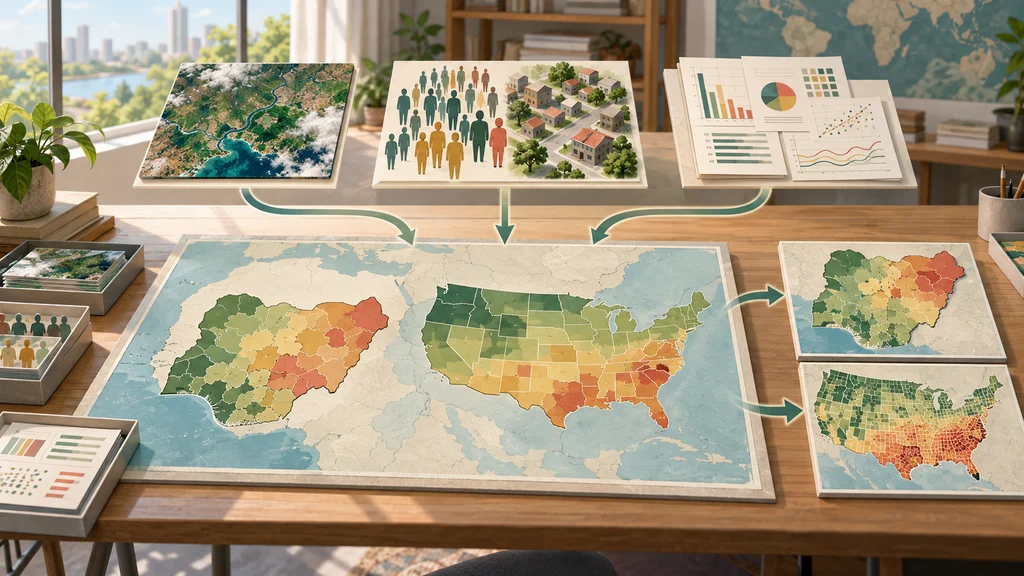
地理空間予測で、学習用データを人が整える工程までAIによる自動化が広がった。Googleの研究用システムPPEは、自然言語の指示からデータを探し、特徴量作成、モデル学習・評価までを実行する。Googleの評価では、健康指標の予測や食料安全保障情報の詳細化で比較対象を上回った。
予測したい内容を地域と期間の条件へ変換する
Googleが開発した研究用の地理空間予測システムPlanetary prediction engine(PPE)は、自然言語で与えられた予測課題を、データ取得からモデル評価、レポート生成までの処理へつなぐ。最初に指示を空間粒度、データを結び付けるキー、対象期間へ変換し、どの地域のどの時点を予測するかに合わせて情報を選ぶ。
情報の選択では、予測に役立つ要因について仮説を立て、文献と照合する。説明変数はデータ基盤のData Commonsや地理空間データ処理基盤のGoogle Earth Engineから取得し、そこにない情報は実行時に政府ポータルや学術リポジトリを探索する。
統計データと基盤モデルの表現を統合する
収集した説明変数には、学習済みの地理空間基盤モデルが持つ埋め込み表現を組み合わせる。人口・社会属性の特徴はPopulation Dynamics Foundation Models(PDFM)、衛星画像の特徴はAlphaEarthから取り込み、統計データとともに予測モデルの入力へまとめる。
入力候補を整える際には、検査機構のFeature Gateが目的変数の情報漏洩を抑える。予測対象を数学的に構成する値、予測対象と共通の調査に由来するデータ、因果関係の下流にある結果、未来のデータという4基準で候補を検査し、予測の答えにつながる情報が入力へ紛れ込むのを防ぐ。
複数のモデルを探索し、汎化の失敗を修正する
整えた入力を受け取る学習・評価段階では、正則化線形モデル、勾配ブースティング決定木、多層パーセプトロンなどを探索する。過学習を抑える機構Overfitting Guard Protocolは、データセットのリスクを事前に評価し、汎化の失敗を検出すると修正するループを実行する。
データ選択、データセット整備、モデル構築・予測という3段階は、それぞれLLMが制御する。段階間ではデータ本体をLLMのプロンプトへ展開せず、データを参照するためのハンドルを渡すことで、コンテキストウィンドウの制約を回避する。
健康指標の予測と食料安全保障情報の詳細化で比較
Googleの評価では、米疾病対策センターの21の健康指標を予測する課題で、PPEの平均決定係数R²は0.768だった。専門家が手作業で構築した処理系の0.600を上回り、データ選択と基盤モデルの表現を組み合わせた自動処理で予測性能の改善を示した。
ナイジェリアの食料安全保障では、州単位の情報から、より細かな地方行政区単位の推定を作る課題を評価した。地域の市場ショック、食料価格の異常、微気候の指標を自動で統合した結果、R²は比較対象の0.315に対して0.661となった。