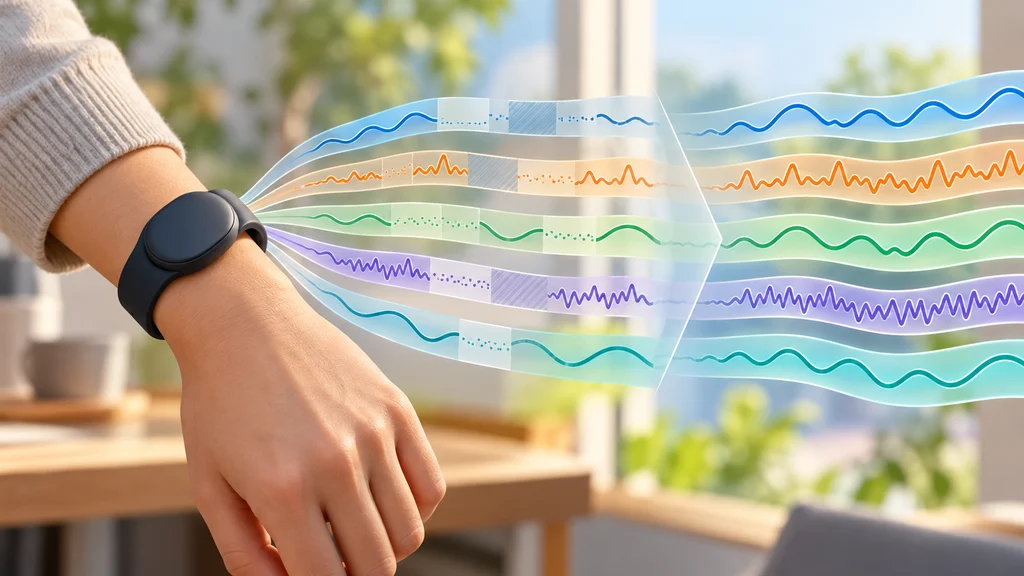
欠測を含むウェアラブルデータから学んだ共通表現が、複数の健康関連予測に使えるようになった。Googleの基盤モデルSensorFMは、エンコーダーを固定した評価で、特徴量を設計した教師ありモデルを35課題中34課題で上回った。
5種類のセンサー記録を24時間単位で学ぶ
Googleが開発したウェアラブルデータ向け基盤モデルSensorFMは、500万人から得た1兆分超のセンサーデータで事前学習した。学習には、健康・ウェルネス研究への利用に同意した参加者の識別情報を除いた記録を使い、100カ国超と20種類超のFitbit・Pixel Watch端末を含めた。
入力は、光電式容積脈波、加速度、皮膚電気活動、皮膚温、高度計測の5種類から得た34特徴量で構成する。各特徴量を1分単位で集約し、24時間の窓としてモデルへ渡す。
実際の欠測を人工的なマスクと同等に扱う
この入力から共通表現を学ぶ際には、ラベルを使わず、隠された部分の再構成を学習する。基になるのは、先行するセンサーモデルLSM-2の手法Adaptive and Inherited Masking(AIM)である。
AIMは、記録に元から存在する欠測に由来するトークンと、学習のために人工的に隠したトークンを同等に扱う。この処理によって、不完全な記録も直接学習に取り込む。
データ量とモデル規模の拡大で再構成損失が低下
Googleは、この再構成学習について、事前学習データを約200万〜20億センサー時間、モデル規模を10万〜1億パラメーターの範囲で変えて評価した。500万人分の全データで学習した最大モデルSensorFM-Bは、最小モデルより再構成損失が31%低かった。
規模の異なるモデルは、学習後の健康関連予測でも比較した。その比較では、最大モデルが35課題中33課題で最良の性能を示した。
共通表現に線形予測器を接続して35課題を評価
健康関連予測の評価には、倫理審査委員会の承認を受けた独立した3件の前向き研究に参加した計13,985人のデータを用いた。35課題は、心血管の健康、代謝リスク、精神的健康、睡眠、人口統計的属性、生活習慣の6区分にまたがる。
Googleは、入力を共通表現へ変換するエンコーダーを固定し、その出力に接続する軽量な線形予測器だけを学習した。この条件で、課題ごとに専用のモデル構成を導入せず、特徴量を設計した教師ありベースラインを35課題中34課題で上回った。