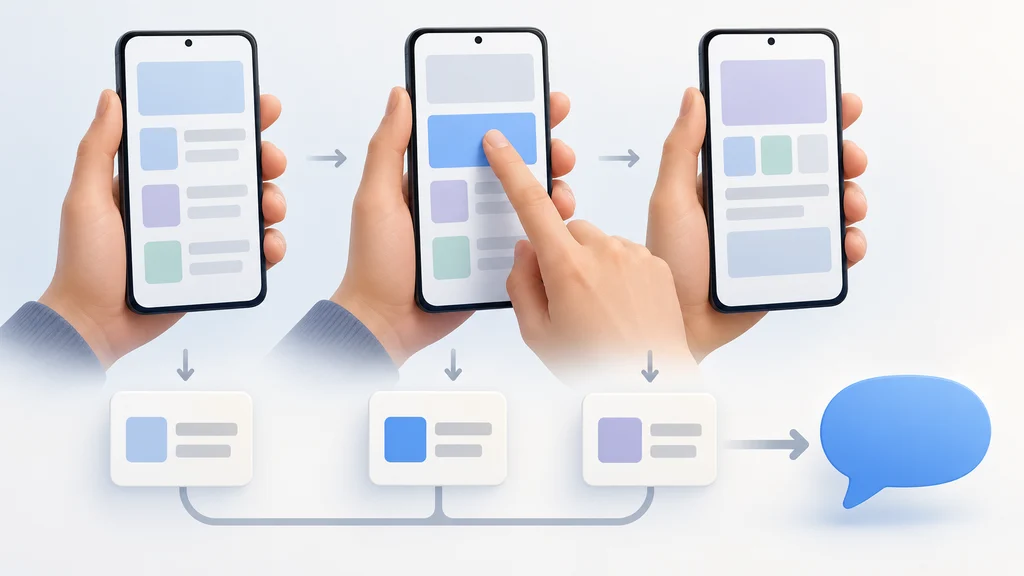
画面操作の履歴を一度に読み解く処理を、画面ごとの要約と意図抽出に分けることで、小型AIの抽出精度が向上した。Googleの評価では、モバイルとWebの操作履歴で比較手法を上回り、モバイルでは大型モデルに匹敵する性能を示した。
前後の画面を使って操作を要約する
Googleが開発した意図抽出手法は、画面ごとの操作を要約する処理と、要約列から履歴全体の意図を読む処理に分かれる。個々の操作を先に言語化し、その出力を一連の出来事として次のモデルへ渡す。
最初の処理では、画像と文章を扱う小型マルチモーダルLLMが、直前・対象・直後の3画面を参照する。対象画面の重要な情報と利用者が行った操作に加え、その操作で何を達成しようとしているかという推測も、別の項目として生成する。
推測を外し、要約に合う正解で学習する
生成した要約列は、ファインチューニングした小型モデルが受け取り、利用者の意図を1文にまとめる。学習には、目的を表す意図文と、その目的に対応する操作列を収めた公開の自動操作データセットを使う。
学習用の正解文は、そのままでは要約から抜け落ちた詳細も含み得るため、別のLLM呼び出しで要約にない情報を削除する。この修正は、入力に現れない詳細を補うようモデルに学習させることを避けるために行う。
推論時には、最初の処理で生成した操作目的の推測も、意図抽出への入力から取り除く。Googleの評価では、要約時には推測を生成させ、意図を抽出するときには使わない組み合わせが性能を改善した。
意図を事実に分け、欠落と誤った追加を測る
抽出した意図の評価には、Bi-Factという手法を使う。評価用のLLMが予測文と正解文をこれ以上分割できない事実に分解し、正解の事実を予測がどれだけ含むか、予測の事実が正解にどれだけ裏付けられるかを調べる。
この双方向の照合から、正しい情報の割合を表す適合率と、正解を拾えた割合を表す再現率を計算し、両者をまとめたF1スコアを求める。さらに事実が各段階を通る過程を追い、要約時と意図抽出時のどちらで情報が失われたり、根拠のない情報が加わったりしたかを分析する。
モバイルとWebで直接処理する手法を上回る
Googleは、思考過程を促す指示を与えるChain of Thoughtと、操作履歴から意図を直接出力するEnd-to-Endのファインチューニングを比較対象にした。Bi-FactのF1スコアでは、モバイルとWebの操作履歴を対象としたAIモデル系列GeminiおよびQwen2の各設定で、2段階方式が両方の比較手法を上回った。
モバイルの操作履歴では、小型モデルGemini 1.5 Flash 8Bに2段階方式を適用した結果、大型モデルGemini 1.5 Proに匹敵する意図抽出性能を示した。これは操作履歴から意図を読む評価で得られた結果であり、端末内での運用開始を示すものではない。