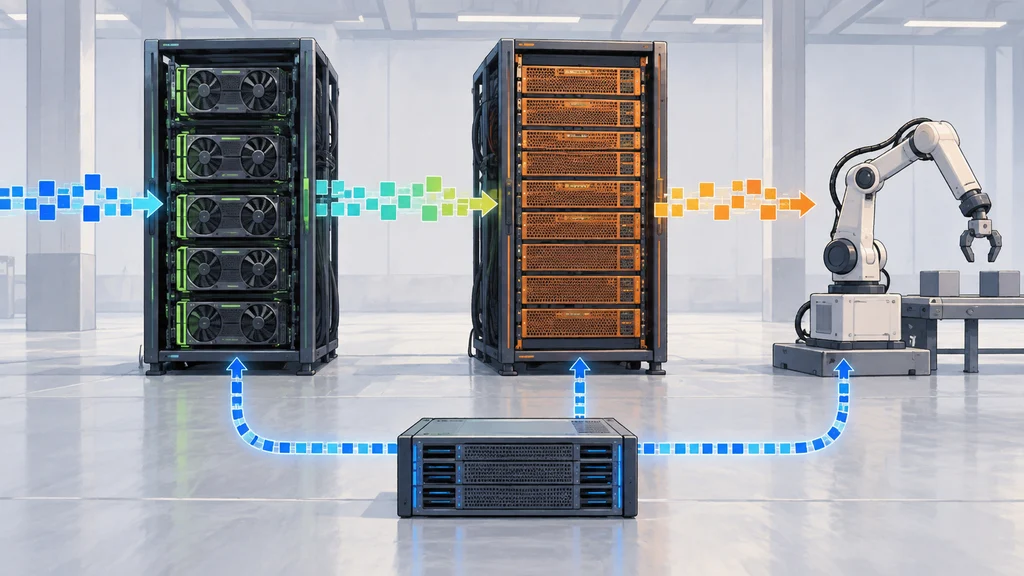
エージェント型AI推論の工程を、GPU、SambaNovaのRDU、Intel Xeon 6に分けて処理する設計が示された。入力を処理するprefill、出力を生成するdecode、ホストとアクション処理に、それぞれ役割を割り当てる。
推論の工程ごとに演算器を割り当てる
IntelとSambaNovaは、GPU、SambaNovaのRDU、Intel Xeon 6を組み合わせるエージェント型AI推論の共同設計を示した。両社は、この共同設計に関する契約を締結している。
GPUがprefill、RDUがdecodeを担う
推論の前段に当たるprefillはGPUが担当する。後段のdecodeにはSambaNovaのRDUを割り当て、高スループットで処理する設計とした。
Xeon 6をホストとアクション処理に配置
Xeon 6はホストCPUとアクションCPUを担う。IntelとSambaNovaは、このCPUを含む構成によって、データセンターで使われるx86系ソフトウェアとの互換性を保つとしている。
企業とクラウド向けに2026年後半の提供を見込む
共同設計する製品は、企業、クラウドプラットフォーム、主権AI向けに2026年後半の提供が見込まれている。今回示されたのは、各工程に演算器を割り当てる設計と提供予定である。