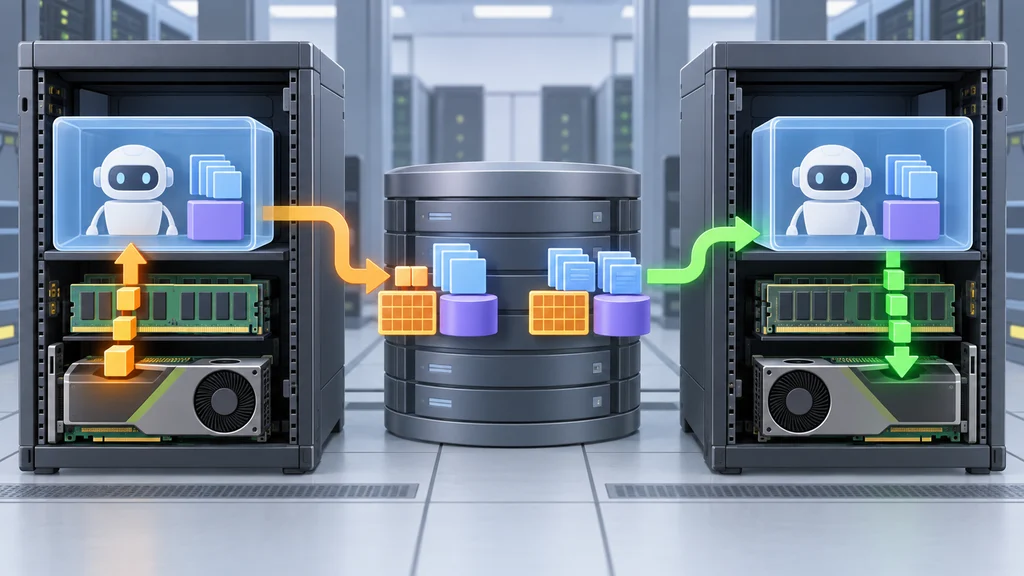
初期化済みのAI推論ワーカーを保存し、GPUとコンテナの状態を戻すことで、起動時の処理を省けるようにする。NVIDIAの初期試作「Dynamo Snapshot」は、この復元をKubernetes上のワーカーに適用する。
初期化済みワーカーを保存する理由
Kubernetes上の推論ワーカーは、コールドスタートに数分かかる場合がある。NVIDIAが開発したDynamo Snapshotは、稼働中のワーカーの状態を保存・復元し、この起動時間を短縮するための初期試作だ。
Dynamoのワーカーは、まずエンジンを初期化し、モデルの重みを読み込んでカーネルをウォームアップする。初期化を終えたワーカーは、次の段階で制御系に接続し、ほかの構成要素から発見できるように登録される。この二つの段階の間に、保存する状態を整える必要がある。
GPUとホストの状態を二段階で保存
ワーカーの状態はGPU側とホスト側に分かれる。cudaドライバーのチェックポイント機能は、GPUのコンテキストやメモリーなどの状態を、そのコンテキストを持つプロセスのCPUメモリーへ書き出す。
続いてCRIUが、CPUメモリーやスレッドなどを含むプロセスツリーの状態をストレージへ保存する。復元されたプロセスは保存時の命令位置から実行を再開し、GPUの状態もCPUメモリーに保存された内容から戻される。
外部接続の前にワーカーを静止させる
制御系への登録後にワーカーを保存しようとすると、外部との有効なTCP接続が障害になる。Dynamo Snapshotでは、ワーカーの停止・再開用フックによって保存前の処理を静止させる。
ワーカーは復元完了を知らせる外部信号が届くまで待機する。この手順により、エンジンの初期化で得た状態を保存する処理と、復元後に外部の構成要素へ接続する処理を分けられる。
コンテナのファイルも別ノードへ引き継ぐ
Kubernetes上では、特権付きDaemonSetが各ノードにエージェントを配置し、runc管理下のコンテナを保存・復元する。エージェントはワーカーの準備完了を待ってcuda-checkpointとCRIUを実行し、コンテナの書き込み可能なファイルシステム層も保存する。
復元時には仮のポッドを起動し、その名前空間へファイルシステム、プロセス、GPUの状態を戻す。チェックポイントを共有ストレージに置く構成のため、保存元とは別のノードでもワーカーを復元できる。