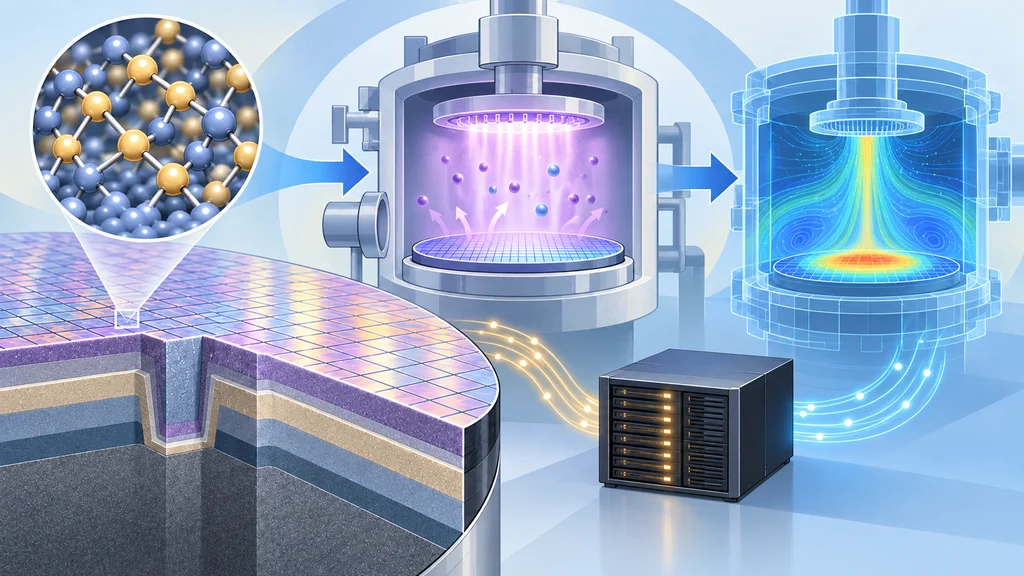
半導体の材料解析と製造工程のシミュレーションをGPUで高速化し、材料探索から工程開発までをつなぐデジタル開発モデルが構築された。材料の計算結果を製造条件の検討へ引き継ぎ、工程内の挙動をリアルタイムで確認できる。
原子スケールの材料特性をデバイス予測につなぐ
Applied MaterialsとNVIDIAは、原子スケールの材料探索、製造工程の開発、工場の最適化をつなぐデジタル開発モデルを構築した。出発点となる材料評価では、Applied Materialsのシミュレーション基盤Ginestraが、計測データと第一原理シミュレーションを組み合わせる。
Ginestraは原子スケールの材料特性から、デバイスのばらつきと信頼性を予測する。材料の候補を製造工程へ進める前に、その特性を計算上で調べる役割を担う。
疎行列の計算を速め、材料候補の探索範囲を広げる
Ginestraには、疎行列の計算を高速化するNVIDIA cuDSSが組み込まれた。疎行列は値の大部分がゼロである行列で、Ginestraのシミュレーションではその計算が中核を占める。
NVIDIAによると、cuDSSを組み込んだ計算はCPUのみを使う手法より最大10倍速く、精度も維持する。処理時間の短縮により、技術者は材料の組み合わせや反応経路について数千件の仮想実験を実行できる。
電子構造の計算をCPUの5日からGPUの約2時間へ
材料の電子構造を調べる密度汎関数理論の計算にもGPUを使う。NVIDIA cuESTは、ガウス基底を用いる計算のうち、負荷が高い部分を高速化する。
NVIDIAによると、64個のCPUコアで5日かかっていたシミュレーションは、1基のNVIDIA B200 GPUで約2時間になった。この比較は、材料特性を予測する計算を短時間で繰り返すうえでの処理時間の差を示している。
複合的な工程計算をリアルタイムの再現へ渡す
材料の候補を製造条件へ落とし込む段階では、Applied Materialsの工程シミュレーション基盤ACE+が、流体、熱、プラズマ、表面反応などを組み合わせて計算する。これにより、処理室の設計や装置構成、製造条件が互いにどう影響するかを調べる。
NVIDIA PhysicsNeMoはその計算結果を、工程の挙動をリアルタイムで再現するデジタルツインへ変換する。NVIDIAによると、GPUで高速化したACE+の表面形状シミュレーションは最大35倍速くなり、従来は数日かかった作業を当日中に終えられる。技術者は条件を変えながら影響を即座に確認でき、バッチ単位の反復から対話的な検討へ移れる。