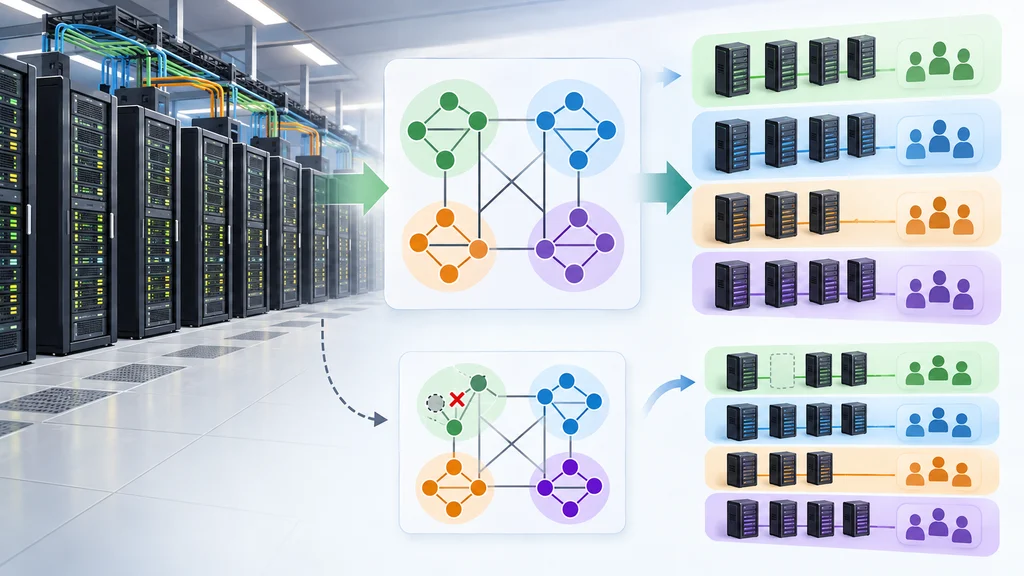
GPUクラスタの接続関係を検出し、AIジョブの配置に使う情報へ変換するオープンソースツール「NVIDIA Topograph」が公開された。クラスタの変化に応じて接続情報を再生成し、KubernetesやSlurmへ渡す。
GPU間の通信経路がジョブの配置を左右する
分散した学習・推論では、GPU間でデータが継続的に交換される。NVIDIAは、密接に通信するジョブを離れた接続領域へ分散すると、共有する通信経路で競合や遅延が増え得ると説明している。
オープンソースツールのTopographは、クラスタ内の機器がネットワーク上でどう接続されているかを特定する。その情報をジョブ管理システムへ渡し、接続関係を考慮した配置判断に使えるようにする。
異なる環境の接続情報を共通モデルにそろえる
Topographのproviderは、クラウドAPIまたは施設内のネットワークシステムから接続関係を検出する。取得した情報を共通の内部モデルへ正規化するため、情報源ごとの差を後段の出力処理へ持ち込まずに済む。
クラウド環境では、Google Cloud、Lambda、Nebius、Nscale、Oracle Cloud Infrastructureとの連携に対応する。これらの環境から得た接続関係も、ジョブ管理システムへ渡す前に同じモデルで扱う。
共通モデルをジョブ管理システムの形式へ変換する
共通モデルを受け取るengineは、接続情報をKubernetesのノードラベル、Slurmの接続構成、SlinkyのConfigMapなどへ変換する。情報源に合わせる処理と利用先に合わせる処理を分けた構成だ。
SlurmとKubernetesは、接続関係を考慮した割り当てに対応している。ただし、配置判断に使えるのは各システムが把握している接続情報に限られるため、変換後の情報をクラスタの状態に合わせて更新する必要がある。
ノードの変化を受けて配置用の情報を再生成する
TopographのNode Data Brokerはノードごとの属性を集め、ノードのアノテーションとして保存する。Node Observerは設定されたKubernetesノードやPodの変化などを監視し、接続情報の再生成を要求する。
再生成は明示的な要求時にも、監視対象のクラスタ変更時にも実行される。これにより、ジョブ管理システムへ渡す接続情報を、手動で維持する固定的な情報に頼らず更新する。