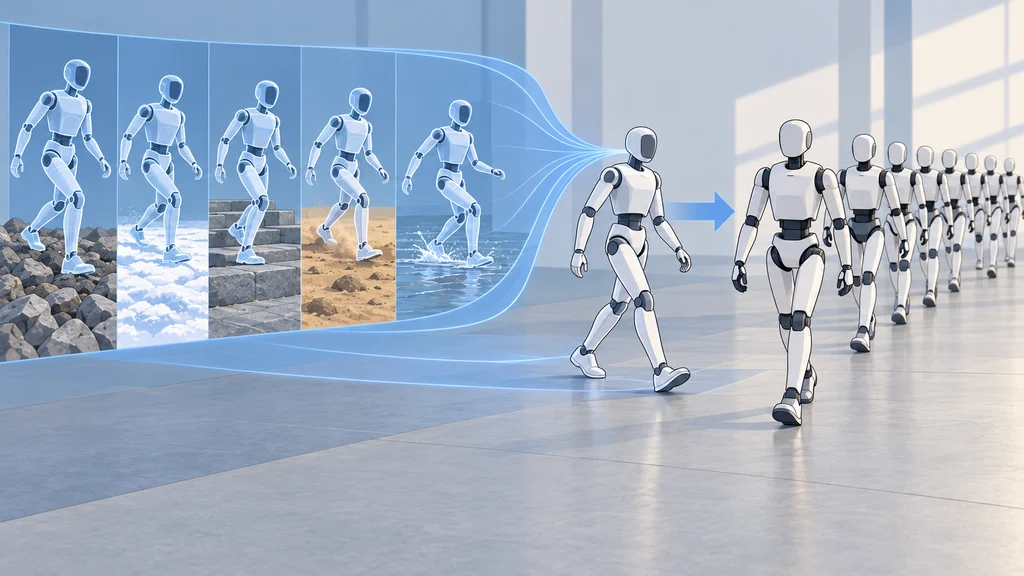
シミュレーションで強化学習した歩行制御が、人型ロボットの実機へ追加調整なしで移された。Figure AIは、同じニューラルネットワークで10台のFigure 02を動作させたとしている。
数千体の仮想ロボットで一つの歩行方策を学ぶ
Figure AIは、人型ロボットFigure 02向けの歩行制御用ニューラルネットワークを、GPUで加速した物理シミュレーション内で強化学習させた。物理パラメーターが異なる数千体の仮想ロボットを並列に動かし、一つの歩行方策を学習させている。
仮想ロボットには地形や駆動部の動特性の違いを与え、つまずき、滑り、外部からの押しも学習条件に含めた。Figure AIは、この並列シミュレーションで数年分に相当するデータを数時間で生成したとしている。
人間の歩行軌道を報酬に組み込む
強化学習では、与える報酬によって方策が選ぶ動作が変わる。人間らしい歩き方へ導くため、歩行方策には人間の歩行を示す参照軌道を模倣する報酬を与えた。
目標とする動作には、かかとからの着地、つま先での蹴り出し、脚と同期した腕振りが含まれる。さらに別の報酬項目で、目標速度への追従、消費電力、外力や地形の変化に対する頑健性を最適化した。
物理特性のばらつきとトルク制御で実機へ移す
シミュレーションで得た歩行方策を実機へ移すため、学習時には仮想ロボットごとの物理特性をランダムに変えた。単一の設定だけで学ぶことを避け、異なる物理条件を方策に経験させる構成だ。
実機では、歩行方策の出力にkHz帯の閉ループ式トルクフィードバック制御を組み合わせ、駆動部のモデル化誤差を補う。Figure AIによると、この構成でシミュレーションから実機へ歩行方策を追加調整なしで適用できたという。
同じニューラルネットワークが実機10台で動作
Figure AIは、歩行方策がロボット間の違い、床面の摩擦変化、外部からの押しに対応し、繰り返し人間らしい歩行を生み出したとしている。シミュレーションで与えたばらつきと実機側のトルク制御を組み合わせた結果として示す動作だ。
10台のFigure 02は、変更を加えていない同一の強化学習済みニューラルネットワークで動作した。ロボットごとに歩行用ネットワークを作り直さず、共通の方策を複数の実機に適用した事例となる。