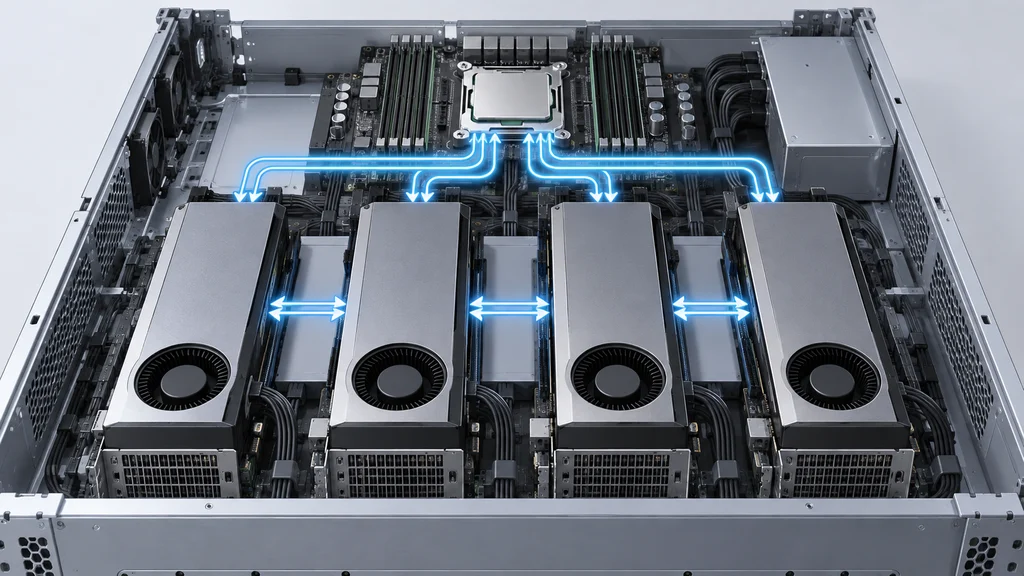
IntelのAI推論用GPU「Arc Pro B70」を4基使う構成は、MLPerf Inference v6.0でArc Pro B60の4基相当構成に対し最大1.8倍の推論性能を示した。複数GPUを使う推論基盤では、メモリー容量とソフトウェアの最適化も大規模モデルの実行を支える。
4基のGPUで1200億パラメータのモデルを実行
IntelのMLPerf Inference v6.0への提出結果には、サーバー用CPUのXeon 6とAI推論用GPUのArc Pro B70を組み合わせたシステムが含まれる。CPUがホスト側の処理を担い、GPUがモデルの推論処理を受け持つ構成だ。
Intelによると、Arc Pro B70またはB65を4基使う構成では、GPUのメモリー容量が合計128GBになる。この構成で1200億パラメータのモデルを、高い同時実行数で動かしたという。
コンテナ化したソフトウェアが複数GPUを扱う
Intelは、Linux環境向けにコンテナ化したソフトウェア構成を、複数GPUでの推論処理に合わせて最適化したとしている。モデルを動かすためのソフトウェアをまとめ、GPUを増やした構成にも対応させる。
複数GPU間のデータ移動には、PCIe P2P転送を構成要素として挙げている。P2PはGPU同士でデータを転送する方式で、複数のGPUを使う推論処理をつなぐ。
B70の4基構成はB60の4基相当構成を上回る
IntelのMLPerf Inference v6.0での比較では、Arc Pro B70を4基使う構成の推論性能が、Arc Pro B60の4基相当構成に対して最大1.8倍だった。両構成はホストCPUにXeon 698Xを使用しており、この数値はIntelが示した測定条件での最大値を表す。
ソフトウェアの変更も測定値に反映された。Intelによると、同じArc Pro B60のハードウェア構成を使った比較では、最適化を加えたv6.0の推論性能がv5.1に比べて最大1.18倍になった。
ホストCPUが推論要求とメモリーを管理
GPUが推論の演算を担う構成でも、ホストCPUには処理が残る。Intelは、CPUがメモリー管理、処理の割り当て、負荷の分配を担うと説明している。
IntelはMLPerf Inferenceに、GPUを使わないCPU単独の結果も提出している。GPUを組み合わせたシステムのホストとしてだけでなく、CPUだけで推論を実行する構成も評価対象に含めた。