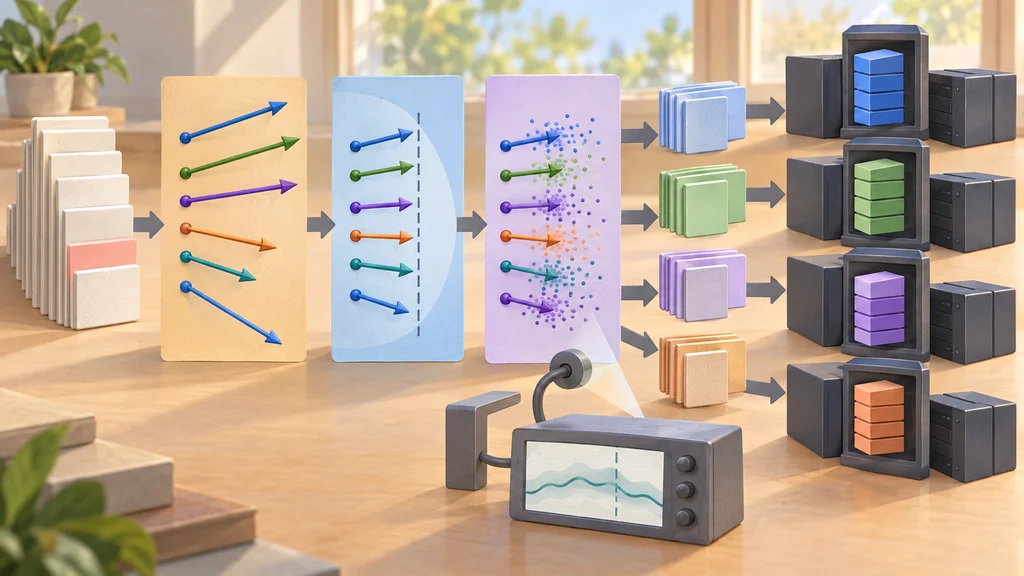
差分プライバシー学習の処理を部品として組み合わせ、複数の計算装置へ分散する学習に組み込む。Googleが公開したJAX-Privacy 1.0は、勾配の制限やノイズ生成に加え、プライバシー損失の計算と監査を扱う学習用ライブラリだ。
勾配の制限とノイズ付加を組み合わせる
差分プライバシーは、一人または一つの学習例をデータセットに含めるかどうかで、処理の出力が変わる程度を制限する。Googleが公開した学習用ライブラリJAX-Privacy 1.0は、この保護をモデル学習へ組み込むため、処理を部品として組み合わせやすい構成へ再設計された。
基本部品には、学習例ごとの勾配の大きさを制限する勾配クリッピング、ノイズ付加、バッチ構築がある。これらを組み合わせることで、差分プライバシーを備えた確率的勾配降下法DP-SGDを構築することができる。
ノイズ生成をデータ並列・モデル並列へ接続する
ノイズを使う学習手法として、反復間で相関を持つノイズを注入するDP matrix factorizationにも対応する。Googleによると、各部品は数値計算ライブラリJAXの並列処理機能と連携し、データ並列とモデル並列を必要とする大規模モデルの学習に利用できる。
分散環境で扱うバッチには、大きく、サイズも変動するものがある。ライブラリはその処理に向け、バッチを小分けにするmicro-batchingと、サイズをそろえるpaddingを備える。
数学的な損失計算に実測の監査を重ねる
学習へ加えるノイズ量の調整には、Googleの差分プライバシー会計ライブラリを使う。プライバシー会計は、学習処理に伴うプライバシー損失の数学的な上限を扱う。
その上限を補う仕組みとして、既知のデータ点であるcanariesを注入する監査手法も実装できる。各ステップで監査指標を計算し、学習処理のプライバシー損失を経験的に評価する。
研究の再現用から大規模言語モデルの学習へ
JAX-Privacyの初版は2022年、Googleによるプライバシー保護学習の研究成果を外部の研究者が再現・検証できるようにする目的で導入された。Googleは、このライブラリの部品を、差分プライバシーを備えた大規模言語モデルVaultGemmaの学習にも使用した。
公開版には、機械学習フレームワークKerasを使い、公開モデル群Gemmaのモデルをファインチューニングする実行可能なコード例が含まれる。コード例は対話要約と合成データ生成を対象とし、差分プライバシー処理をモデルの追加学習へ組み込む手順を提供する。