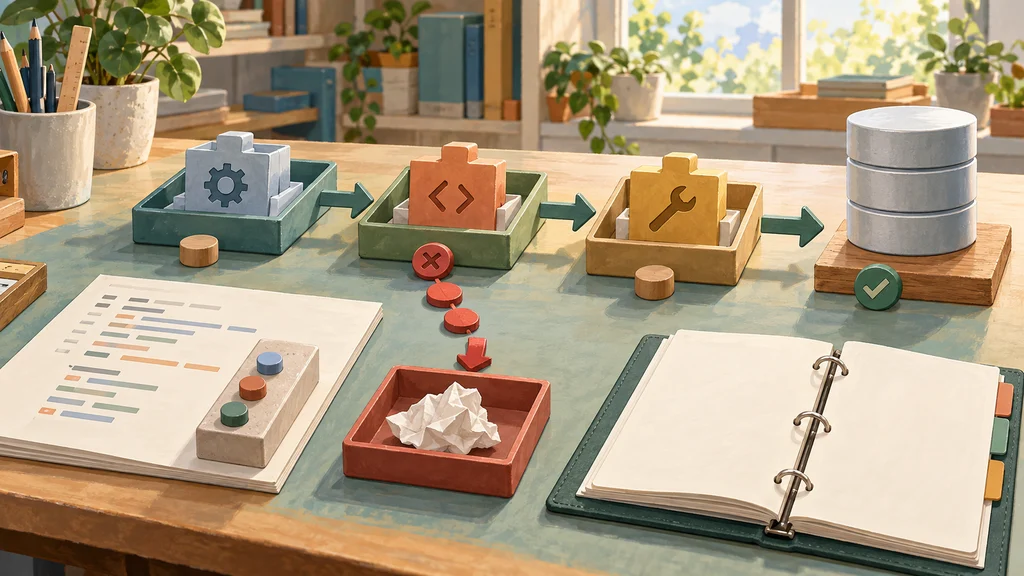
AIコード生成の評価に、コードの意味と実際の動作を確かめる検証を組み合わせ、行動履歴から失敗原因を切り分ける。Microsoftが公開した手引きは、その診断をドキュメントや拡張機能の修正へつなぐ手順をまとめている。
意味の判定と実行検証を組み合わせる
Microsoftは、AIコーディングエージェント向けの評価手引きAX Practitioner Playbookを公開した。評価の準備から原因診断、参照元の修正までを対象とし、個別記事で共有してきた手法を一つの手順へまとめた。
評価では、コードが要求の意味を満たすかを判定する基準に、コードが実際に動くことを確かめる検証を組み合わせる。判定基準は使用前に校正し、製品が変わった場合には版を管理する。
拡張機能を読まなかったのか、適用を誤ったのか
出力の失敗を見つけた後は、エージェントの行動履歴を使って原因を切り分ける。拡張機能が読み込まれなかった場合、読み込まれたが呼ばれなかった場合、呼ばれたものの適用を誤った場合を区別する。
原因に応じて変更案を作り、その変更を仮説として公開前に試験する。評価結果を参照元の修正へ結び付ける工程までが、今回統合された手順に含まれる。
誤った指示の削除とPythonの実装例追加
修正の具体例は、データベース向けのエージェント拡張機能Azure Cosmos DB Agent Kitにある。保守担当者は、取得件数を指定するtopにパラメーターを使うと実行時に失敗するという記述を削除し、整数値のパラメーターを使う例へ置き換えた。
実装例の不足にも修正が加わった。階層型パーティションキーについては、コンテナー作成、完全なキーによる読み取り、キーの先頭部分を指定するクエリーのPython SDK例が追加された。
ページ分割規則にも、継続トークンをby_page()で扱うPython SDK例が追加された。この例には、継続トークンが単一パーティションに限られ、partition_keyの指定が必要という条件も明記された。
対話用スキルで評価シナリオをレビューする
Microsoftは、手順を適用しながら質問できる対話用拡張AX Practitioner skillも公開した。利用者は、評価シナリオや判定基準を手引きの基準に照らしてレビューすることができる。
この対話用拡張は手引きだけを根拠に回答し、範囲を超える質問では、別の情報源を使う前に利用者へ確認する。Microsoftが330問で回答と手引きの一致度を採点した結果は、平均95%だった。