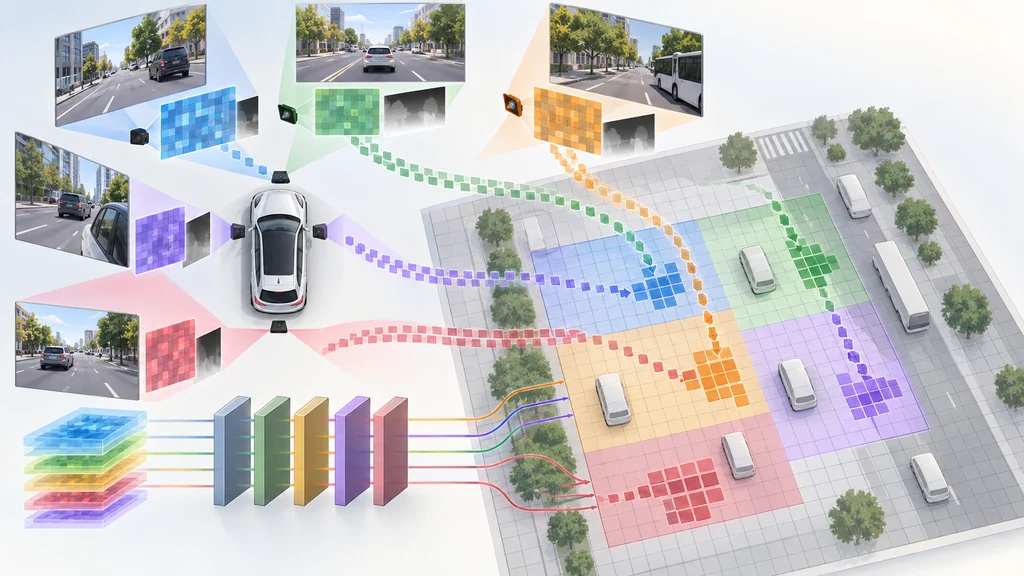
複数カメラの画像特徴を俯瞰グリッドへ集約するGPU演算が高速化した。NVIDIAの測定では、BEVPoolV3はRTX A6000上の所定の構成で従来方式の19.31倍の速度に達した。
深度付きの画像特徴を一つの俯瞰グリッドへ
BEV認識は、複数カメラの画像特徴を共通の俯瞰グリッドへ投影する。その途中にあるBEV Poolingは、画像特徴に深度情報を掛け合わせ、対応するグリッドのセルへ値を集約する。
この集約では、画像側のデータを読み出して俯瞰グリッド上の出力先へ振り分ける。NVIDIAは、この処理に伴うデータの読み込みと索引計算を減らすGPU演算としてBEVPoolV3を示した。
読み込みと索引計算を減らすBEVPoolV3
BEVPoolV3は、同じ深度データを繰り返し読む回数を減らす。集約先の指定には5つのINT32配列からなるscatter mapを使い、索引を事前に計算することで実行時の整数除算もなくす。
出力先は区間ごとに割り当てる。この割り当てによって、複数の処理が出力先を調整するためのatomic操作を避けられる。
49MBの処理データが分ける二つのGPUの条件
測定に使った標準構成には約20万9000の集約点と80の特徴チャネルがあり、BEV Poolingで扱うデータの合計は約49MBとなる。この規模を踏まえると、演算中にデータをどこから読み出すかがGPUによって異なる。
RTX A6000のL2キャッシュは6MBで、49MBのデータは収まらない。一方、RTX PRO 6000 Blackwell Max-QのL2キャッシュは128MBあり、同じデータを収められる。NVIDIAは、この違いに応じてGPU上の処理を最適化している。
RTX A6000とBlackwellで測った処理時間
NVIDIAの標準構成の測定では、RTX A6000上のBEVPoolV3のFP16経路は90.0マイクロ秒だった。従来のV2に対する高速化率は19.31倍である。
RTX PRO 6000 Blackwell Max-Qでは、V2のFP16経路が274.0マイクロ秒だったのに対し、BEVPoolV3のFP16経路は17.3マイクロ秒、FP8経路は16.4マイクロ秒だった。これらは同じ標準構成におけるGPU演算の処理時間である。