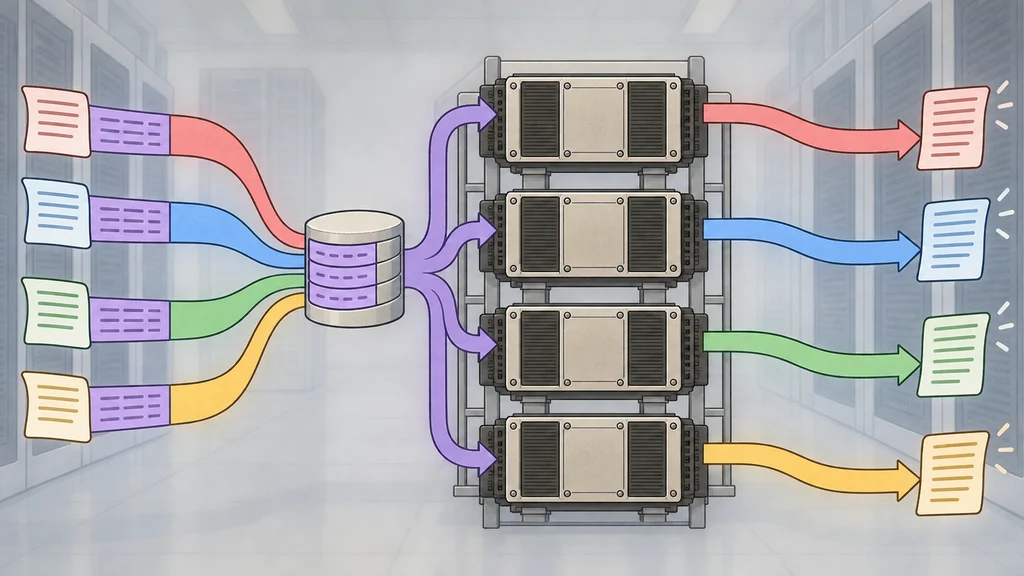
AIモデルの推論で、利用者ごとの応答速度を保ちながらシステム全体の出力を増やす構成が示された。NVIDIAの測定では、Nemotron 3 Ultra向けNIMを4基のB200で動かした際、最適化なしの構成に比べて総出力速度が2.5倍を超えた。
毎秒50トークンの目標で総出力を比較
NVIDIAは、AIモデルのNemotron 3 Ultra向け推論基盤NIM 2.0.12を、4基のB200を使うシステムで測定した。負荷には64Kトークンの入力、400トークンの出力、76%のKV再利用を設定し、利用者あたり毎秒50トークンを性能比較の目標とした。
この条件で、システム全体の出力速度はNIM最適化なしの構成が毎秒718トークン、最適化した構成が毎秒1997トークンだった。NVIDIAは、利用者ごとの出力速度目標を同じに保ちながら、より多くの利用者を同時に処理できるとしている。
モデル分散と専用カーネルで演算を組み立てる
最適化構成では、テンソル並列によってモデル処理を4基のGPUへ分散する。分散した処理には、MoEとMamba向けに自動調整した演算カーネルを使う。
MoE層では、Expertを考慮した実行方式も採用する。こうした並列化と演算の調整は、測定に用いた最適化構成を成す要素であり、個々の要素の効果を足し合わせた数値が総出力速度の測定値ではない。
接頭部分とモデル状態を再利用する
入力に同じ接頭部分が繰り返し現れる場合、接頭部分のキャッシュによってその文脈の再計算を避ける。接頭部分が完全には一致しなくても、部分的な照合で一致した範囲を再利用する。
モデル内部の状態については、Mambaの構造に合わせた状態キャッシュ設定を使う。入力文脈とモデル状態の再利用は、複数の要求を処理する際に繰り返される計算へ対応する。
同時実行の調整に投機的デコードを加える
実行時には、同時処理する系列数やまとめて処理するトークン数を調整する。ブロックサイズとGPUメモリーの割り当ても、利用者あたりの出力速度目標を守りながら処理を進めるための設定に含まれる。
NIM 2.0.12の最適化構成には、MTPによる投機的デコードと関連する修正も加わる。MTPの上乗せ効果は、予測したトークンの採用率と利用可能なメモリーの余裕に左右されるため、総出力速度の差をMTP単独の効果とは扱えない。