独自AIアクセラレーターを、通信からラック設備まで既存のAI計算基盤へ組み込む接続基盤NVLink Fusionの構成が示された。NVIDIAは、XPU間通信とCPU接続を提供し、GPUシステムと冷却・給電・管理設備を共通化できるとしている。
独自XPUを72基の通信領域へ組み込む
NVIDIAの接続基盤NVLink Fusionは、独自設計のAIアクセラレーターであるXPUを、NVLinkのスケールアップ通信領域へ接続する。第6世代NVLinkは72基のXPUを結び、アクセラレーター間でデータをやり取りする経路を提供する。
NVIDIAによると、このXPU間通信のパケット処理レートは、市販Ethernetに基づく代替構成の10倍となる。この比較の対象は通信のパケット処理レートであり、AIモデル全体の処理量を示す数値ではない。
CPU接続にはNVLink-C2Cを使う
XPU間の通信に加え、CPUとの接続にはチップ間接続技術NVLink-C2Cを使う。NVLink Fusionはこの接続を含み、NVIDIAのVera CPUや他の対応CPUとXPUを組み合わせることができる。
NVIDIAは、このCPU接続のエネルギー効率がPCIeインターフェースの最大6倍だとしている。比較対象は接続インターフェースで、ラック全体の電力効率とは区別される。
XPUとGPUでラック設備を共通化する
通信とCPU接続を備えたXPUシステムは、ラック規模の設計基盤NVIDIA MGXと、その採用システムに使われる供給網を利用できる。独自アクセラレーターを組み込む際にも、ラックの設計と部品調達に既存の基盤を使う構成だ。
NVIDIAによると、統一アーキテクチャではXPUシステムとGPUシステムが、ラックの設置寸法、ネットワーク、冷却、給電、管理システムを共通化できる。設備側の共通化は、アクセラレーターだけでなく、建物、電力、冷却、計算、ネットワークを共同設計するNVIDIA DSX参照アーキテクチャへの対応につながっている。
稼働を続けながら保守し、混在基盤を管理する
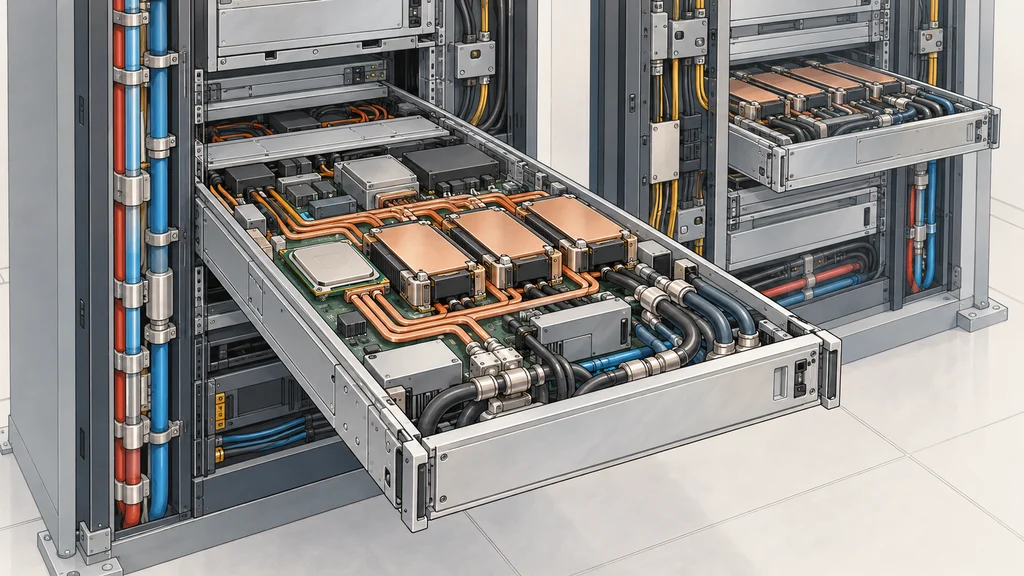
共通ラックの参照設計では、計算トレーを全液冷とし、ラックの残りの部分を稼働させたままトレーを取り外すことができる。保守対象をトレー単位で切り離せる構成を、計算機の配置と冷却に組み込んでいる。
NVIDIAは、混在AI基盤を運用するソフトウェアとして、分散処理ライブラリNCCL、処理分離を担うDynamoとNIXL、クラスタ管理ソフトウェアMission Controlを挙げている。これらが分散処理、処理の分離、状態情報の収集やデバッグをそれぞれ担う。