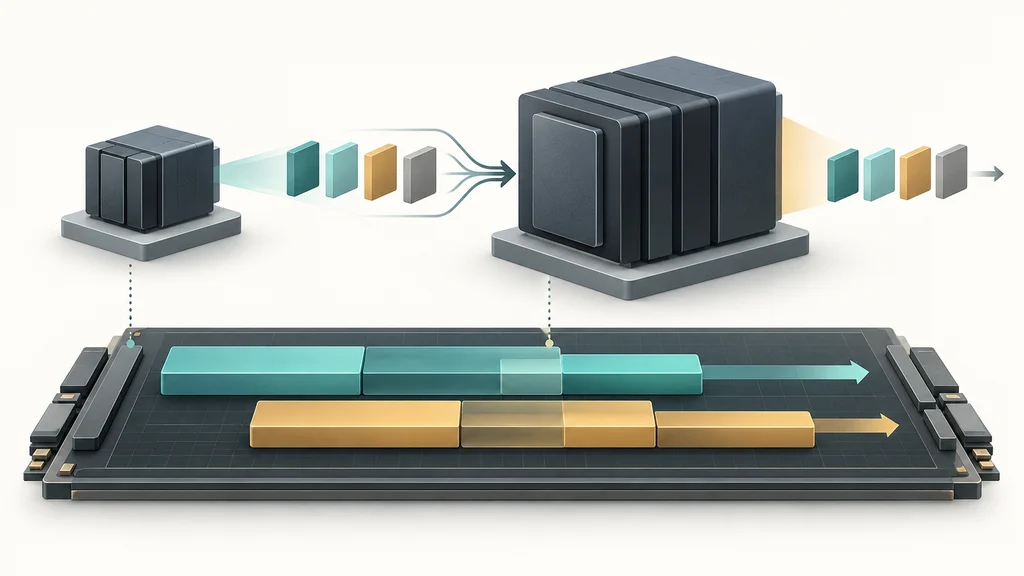
ローカルAIエージェント向けの推論基盤llama.cppが、先読み検証とGPU上の実行順序の改善で高速化した。NVIDIAによると、Qwenの27Bモデルでは推論性能が2倍になった。
27Bモデルと35Bモデルで異なる性能改善
NVIDIAとオープンソース開発者が最適化したAI推論ソフトウェアllama.cppについて、NVIDIAはQwen 3.5とQwen 3.6の27B denseモデルで推論性能が2倍になったとしている。35BのMixture of Experts(MoE)モデルでは1.6倍とし、モデルの構成ごとに異なる性能値を示した。
この高速化には、生成するトークンの検証方法と、GPU上で処理を起動する方法の二つが関わる。前者はモデルが出力を確かめる回数を、後者はカーネルの実行順序を扱う。
後続トークンをまとめて提案し、一度に検証
Multi-Token Prediction(MTP)では、小さな下書きモデルが後続の複数トークンを先に提案する。対象モデルは、その提案を一度の順伝播で検証するため、トークンを一つずつ確かめる処理とは検証の単位が変わる。
MTPに対応済みのモデルなら、この方法を使うための追加学習は要らない。既存モデルの推論処理に適用できることが、ローカル環境での導入条件に関わる。
依存カーネルを同じCUDAストリームで並行実行
GPU側では、Programmatic Dependent Launch(PDL)の更新がデコード処理の実行を速める。依存関係のあるカーネルを、同じCUDAストリーム上で並行して実行できるようにする仕組みだ。
更新前は、こうしたカーネルを同じストリーム上で逐次実行していた。PDLはその実行上の制約を変え、MTPとは別の箇所からllama.cppの推論を高速化する。
vLLMではカーネル選択と実行時負荷も改善
もう一つのAI推論基盤vLLMは、MTPをすでに採用している。追加の最適化では、MoEモデルに使うBF16カーネルの選択を改善し、CUDA Graphsの改良によって実行時のオーバーヘッドを減らす。
NVIDIAによると、これらの追加最適化でvLLMの推論性能は2.6倍に改善する。llama.cppの27Bモデルに示された2倍という値とは、対象となる推論基盤と最適化の範囲が異なる。