量子誤り訂正が生む検出データを学習に使い、量子計算を続けながら制御信号を調整する方式が実証された。Googleは、強化学習によって制御のずれに対処し、人工的なずれを加えた実機試験で論理的な安定性を改善したとしている。
計算中に数千の制御パラメーターを調整
量子プロセッサーの制御には、量子ビットへ送るアナログ信号の調整が必要になる。Googleによると、従来は再較正のために量子計算全体を終了する必要があり、計算と較正を分けて行っている。
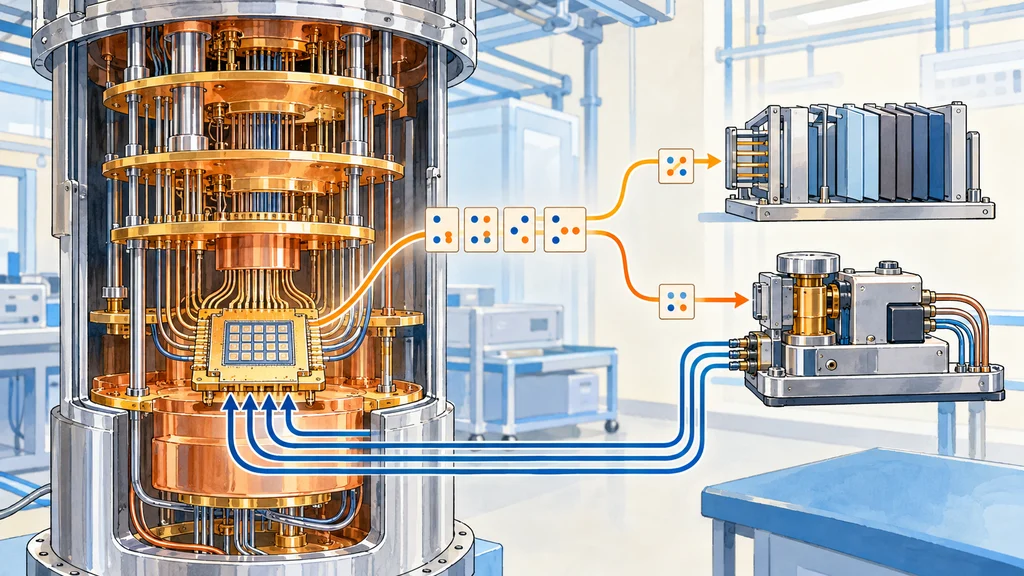
Googleが実証した強化学習方式は、量子誤りの検出データを受け取り、計算中に数千の制御パラメーターを継続的に調整する。計算を進めながら制御を更新するために、誤り訂正が生成するデータを学習にも利用する。
誤りの検出イベントを訂正と学習へ渡す
量子誤り訂正は、多数の物理量子ビットを使って一つの論理量子ビットを構成する。物理量子ビットに対するパリティ検査は、アナログのノイズを二値の誤り検出イベントへ変換する。
誤り訂正のデコーダーは、この検出データから誤りの発生位置を推定し、必要な訂正を計算する。新しい制御方式では、同じ検出イベントが強化学習エージェントの学習信号にもなり、計算の進行中に制御パラメーターを調整して、時間とともに生じる制御のずれであるドリフトに対処する。
人工的なドリフトを加えた実機で安定性を改善
Googleは、超伝導量子プロセッサーのWillowで制御パラメーターに人工的なドリフトを加え、強化学習制御を試験した。この条件では、誤り訂正符号の論理的な安定性が3.5倍に改善し、量子情報を保持する量子メモリーとして信頼できる時間が延びたとしている。
専門家による較正後の追加調整でも、論理誤り率はさらに20%低下した。実験に用いた技術を組み合わせた量子メモリーの論理誤りは、誤り訂正符号のsurface codeでは1000サイクル当たり1回未満、color codeでは100サイクル当たり1回となった。これらは複数の技術を組み合わせた結果であり、強化学習による追加調整の改善率とは区別される。
数百量子ビットの計算モデルで調整速度を確認
制御対象を増やした場合の挙動について、Googleは数百の量子ビットと数万の制御パラメーターを扱う数値シミュレーションを実施した。実機での改善とは別に、より大きなシステムで強化学習制御がどう動くかを検証した。
シミュレーションでは、強化学習が制御パラメーターを改善するにつれて物理誤り率が低下した。その低下の速さはシステムの量子ビット数に依存しなかった。