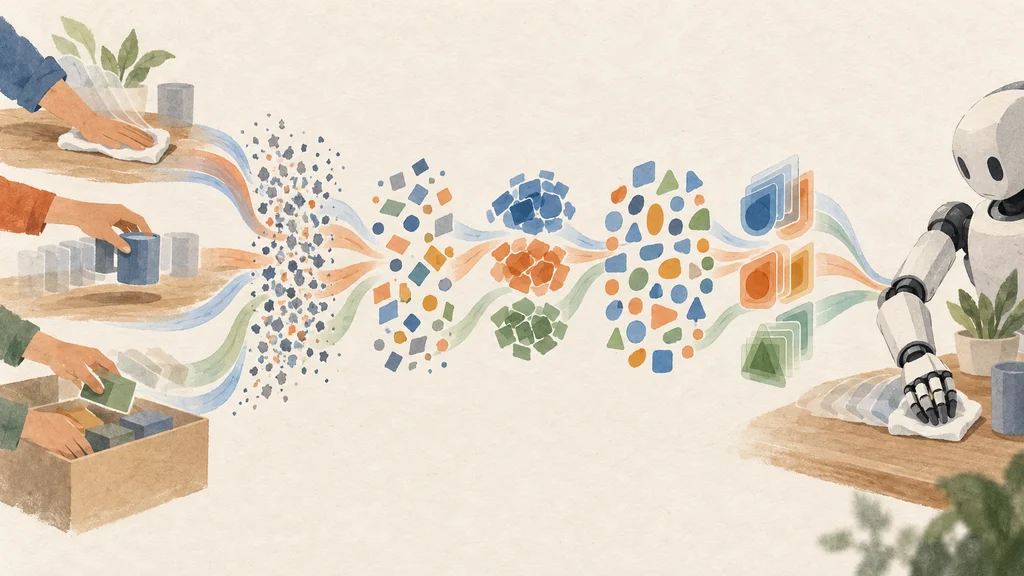
家庭や職場の実作業を撮影した動画が、品質検査、重複除去、再均衡化、説明付与を経てロボット学習用データへ変換されている。基盤は毎秒30分相当のアップロードを処理する。
実世界の作業をHelixの学習入力へ接続
汎用ロボットを多様な状況へ対応させるための物理データはインターネット上にはなく、実世界から集める必要があるとFigure AIは説明している。ロボット学習用データ基盤のIndexは、参加者が家庭や職場で実際の作業を撮影し、その動画をロボット向けAIスタックHelixの学習用に収集する。
Figure AIは当初、外部ベンダーからのデータ購入を試みたが、Helixが求める処理量、多様性、品質を満たせなかったとしている。そのため、実世界の物理データを大規模に収集し、後段の加工へ送る専用パイプラインを構築した。
家庭と事業現場から作業の違いを集める
Indexは、料理、清掃、洗濯などの家庭内作業に加え、物流センター、飲食店、工場、オフィスで行われる作業も収集対象とする。Figure AIは、参加者が増えるたびに異なる環境、見慣れない物体、その人固有の作業方法が加わり、事前に定義しにくい違いを取り込めるとしている。
Figure AIによると、Indexは108カ国で26万4,000件を超えるダウンロードと4万4,000人を超える週間アクティブ利用者を記録し、参加者から1,600万本を超える動画がアップロードされた。データ1,000時間分には、373の異なる作業、1,146の異なる操作対象、116の異なる環境が含まれるという。
毎秒30分相当の動画を5段階へ送る
Indexは毎秒30分相当の動画アップロードを処理している。この流入量を扱うデータ基盤は24時間稼働し、動画を処理する大規模計算を継続するとともに、その後の収集改善を支援するリアルタイムフィードバックを利用者へ返す。
アップロードされた動画は、フィルタリング、不正レビュー、重複除去、再均衡化、アノテーションの5段階を通る。品質や不正、既存データとの類似性を前半で調べ、残ったデータの構成調整と説明情報の付与を後半で進める。
自動検査と人の監査で投稿を絞り込む
最初の自動フィルターは、投稿動画を技術面、映像面、意味面から検査する。続いて人の分析担当者が利用者単位でサンプルを監査し、自動フィルターを意図的に回避しようとする投稿がないかを調べる。
検査後の各映像区間は埋め込み表現へ変換され、受け入れ済みデータとの類似度が計算される。類似度が設定されたしきい値を超えた区間を破棄し、すでに採用した内容に近い映像を後段の処理から除外する。
作業別の配分とクラスタでデータ構成を調整
重複除去後のデータは、投稿内容と利用者が選択した作業との一致度に基づく作業別の割り当て量を使って再均衡化される。さらに埋め込みベースのクラスタを併用し、作業名だけでは表せない映像間の変化もデータ構成へ反映する。
再均衡化の後、パイプラインは各エピソードに対応する階層的なテキストキャプションを生成する。各地から届いた映像は、品質と類似性で選別され、作業内容と映像間の違いに応じて構成を調整されたうえで、内容を示す説明情報を付与される。