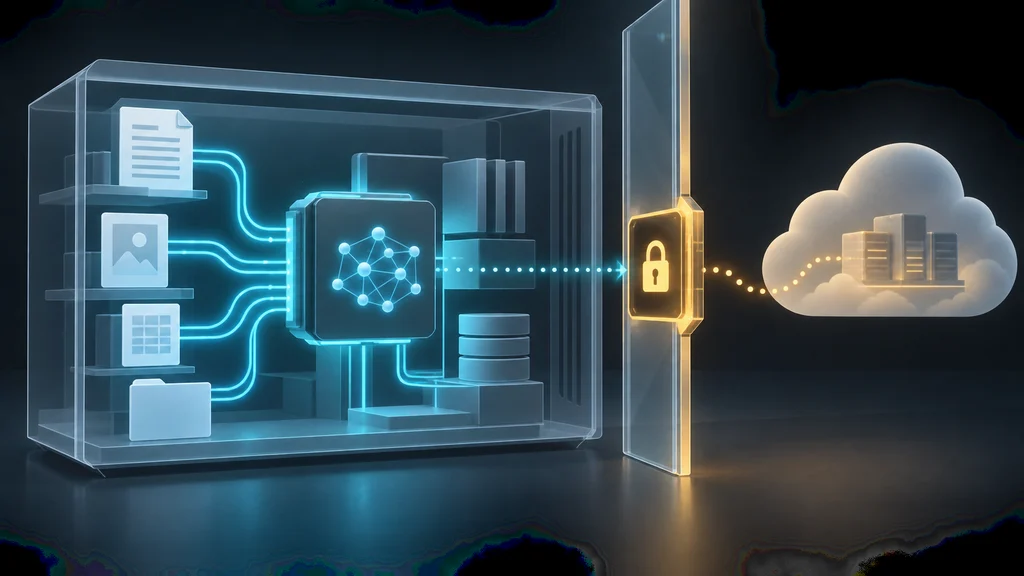
複数段階の作業を進めるローカルAIエージェントが、RTX搭載Windows PCに対応した。機密データは端末内で処理し、高度な推論をクラウドへ移す場合は送信前に利用者の許可を求める。
複数段階の作業をWindows PC上で実行
ローカルAIエージェントのPortable Computerが、対応するNVIDIA GeForce RTX搭載PCとNVIDIA RTX PROワークステーション向けのPerplexityアプリで利用可能になった。Portable Computerは、作業を計画して複数の手順を実行するPerplexity Computerのローカル版に当たる。
対応範囲は、従来のNVIDIA DGX SparkとRTX搭載Linux PCからWindows PCへ広がった。Windows環境では、24GB以上のVRAMを備えたGeForce RTX GPUまたはRTX PRO GPUが動作条件となる。
RTX向けローカルモデルがファイル処理を担う
Portable ComputerはNVIDIA GPUで高速化したローカルモデルを使い、データの分析、複数ファイルに分散した情報の統合、反復作業をPC上で進める。NVIDIAによると、利用者がモデルや複雑なソフトウェア構成を個別に選定しなくても、ローカル処理を始められる設計だという。
ローカルモデルの例として挙げられたQwen 3.8 27Bは、Perplexity Computer向けに追加学習され、NVIDIA RTX GPU向けに最適化されている。このモデルが端末内のデータを入力として受け取り、エージェントが計画した処理を実行する。
端末内処理とクラウド送信を許可で分ける
機密情報をローカルモデルで処理する間、データはPC内に保たれる。端末内で完了した作業はPerplexity Computerのクラウド利用枠を消費しないため、ローカル処理はデータの所在とクラウド資源の利用を同時に切り分ける。
より高度な推論が必要だとPortable Computerが判断すると、クラウドモデルによる支援へ移行できる。この場合、情報を端末外へ送る前に利用者へ許可を求めるため、ローカル処理からクラウド処理への境界を利用者が確認できる。
内蔵ツールとコネクターを作業経路へ接続
Portable Computerは内蔵ブラウザと、隔離された実行環境である独自のSPACE sandboxを利用できる。ローカルモデルによる分析結果を、エージェントがブラウザ操作や実行環境内の処理へ引き渡せる構成になっている。
Microsoft Outlook、OneDrive、Word、Google Drive、Gmail、Slack、GitHub用のコネクターも用意される。これらの接続先を通じて、PC内のファイル処理と日常的に使うアプリ上の作業を一つの複数段階タスクに組み込める。