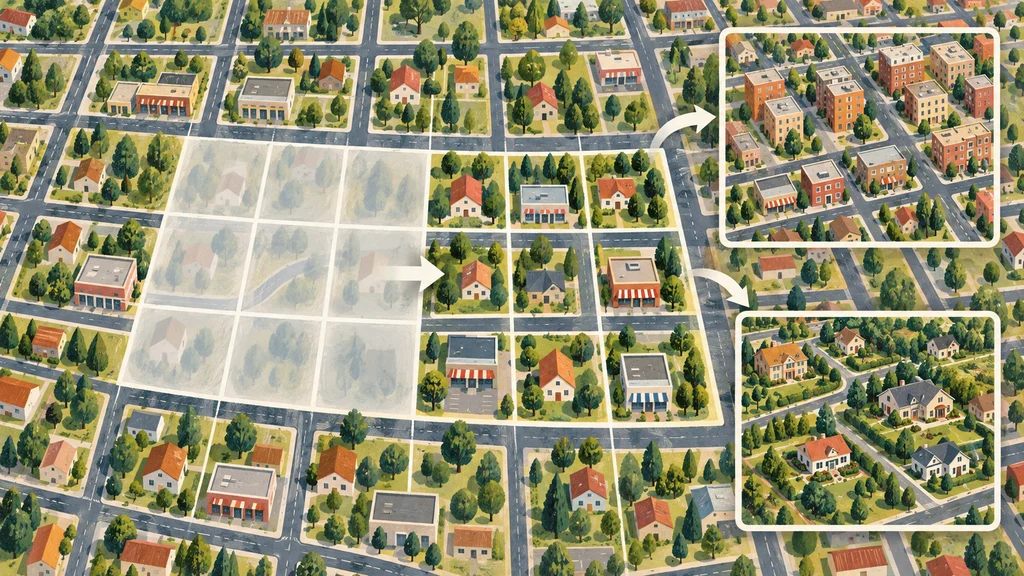
建物や道路、店舗の分布を画像状に並べ、隠した部分を復元する学習から地域の特徴を数値化する。地理空間AIのS2Vecは、この表現を人口密度や所得の予測に利用する。Googleの評価では、未知の地域への適応で強みを示した。
建物や店舗の数を画像の層にする
Googleが開発した地理空間AIのS2Vecは、建物や道路などの人工的な環境を、埋め込みと呼ぶコンパクトな数値表現へ変換する。地域の特徴を共通の表現として学び、異なる予測課題へ利用する自己教師あり学習の枠組みだ。
入力をそろえるため、地表分割用のS2 Geometryライブラリで地表を階層的なセルへ区切る。各セルに含まれる建物や店舗などを種類別に数え、その値を多層の画像として配置することで、座標の集合を画像認識の手法で処理できる形にする。
隠した区画の復元から地域の特徴を学ぶ
画像状になった入力には、Masked Autoencoding(MAE)という、一部を隠して復元する学習手法を適用する。モデルは見えている周囲の情報から欠けた部分を再構成し、地物同士の空間的な関係を学ぶ。
この表現学習には、所得水準などを手作業で付けたラベルを必要としない。課題ごとに指標を作り込む方法に対し、復元学習で得た地域の数値表現を複数の課題へ適応させる構成になっている。
未知の地域の人口密度と所得で比較
Googleは、得られた表現を人口密度、所得中央値、炭素排出量、樹木被覆、標高の予測で評価した。訓練用とテスト用のデータをランダムに分ける設定に加え、未知の地域へゼロショットで適応する設定を設け、地域をまたいだ予測性能も調べた。
この比較では、未知の地域の米国の所得中央値や人口密度を予測する課題で、S2Vecは多くの場合に単独モデル中で最良だった。結果はGoogleが実施した比較評価に基づき、すべての課題で一律に最良だったという意味ではない。
画像の表現を併用すると予測性能が上がる
Googleの評価では、S2Vecの地域表現と画像由来の埋め込み表現を組み合わせると、概して一方だけを使う場合より予測性能が高かった。地物の分布から学んだ情報と、画像から学んだ情報を併用する効果が確認された。
樹木被覆や標高などの環境課題では、人工的な環境のデータだけを使う予測に改善の余地があった。Googleは、衛星画像の表現を組み合わせることで、建物などの数だけでは捉えにくい植生や地形の情報を補えると説明している。