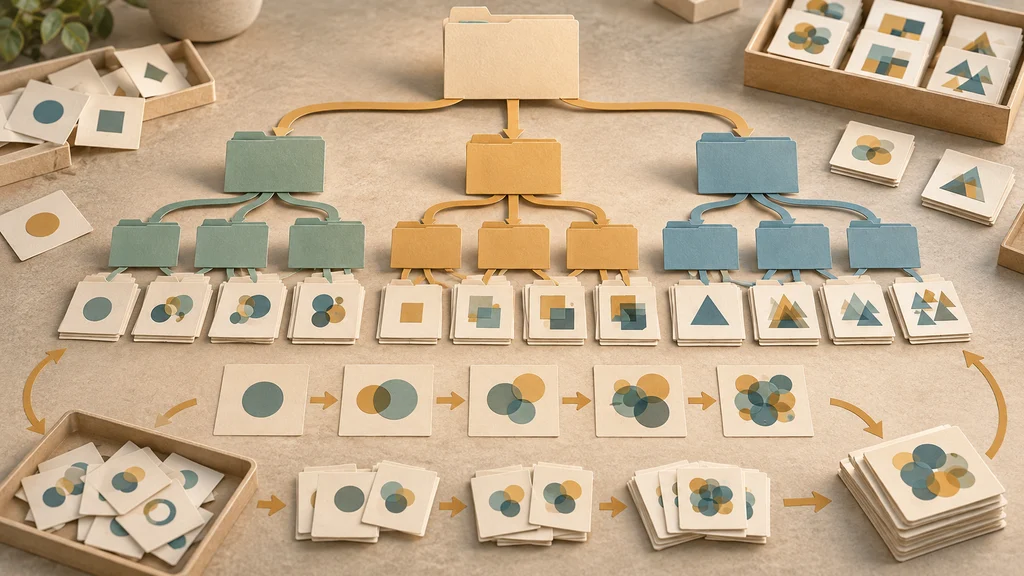
合成学習データの網羅性と難易度を別々に調整する手法Simulaが登場した。対象分野の階層分類を推論で作り、具体例の多様化と回答の品質確認へつなぐ。Googleの評価では、この組み合わせが5つの領域で単純な比較手法を上回った。
種データを使わず、生成範囲を階層分類で決める
Googleが開発した合成データ生成手法Simulaは、人が用意した種データを必要とせず、推論を使ってデータセット全体を設計する。生成対象となる分野を階層分類へ展開し、その分類上でサンプリング戦略を定めることで、どの概念をどれだけ取り上げるかを制御する。
階層分類を作る処理では、推論モデルが各深さで複数の下位分類候補を生成する。批評モデルが候補を評価、統合、選別し、その結果を次の階層の展開へ渡す。この再帰的な処理が、個々の具体例を生成するための分類の骨組みを作る。
同じ概念の具体例を増やし、難易度だけを調整する
分類の骨組みができると、各項目からシナリオを表すメタプロンプトを作る。生成処理は一つのシナリオを複数の異なる具体例へ展開し、同じ概念について表現や状況の異なるデータを用意する。
このメタプロンプトのうち、指定した割合をさらに複雑な内容へ修正する。Googleによると、複雑化する割合を設定することで、意味内容の網羅性を変えずに難易度分布を調整できるという。どの概念を含めるかと、その概念をどれほど難しい問題にするかを別々に扱う構成になっている。
回答の正誤とデータの難しさを別の処理で測る
生成した回答の品質確認には、正しいか誤っているかを独立に判定する二重の批評処理を用いる。もっともらしい回答にモデルが同調する傾向を抑えるため、正誤を別々の判定で確認する。
データセットの性質を測る評価では、Googleは分類上の網羅性を測るTaxonomic Coverageを導入した。難易度にはCalibrated Complexity Scoringを用い、LLMによるバッチ比較から個々のデータへElo形式の評点を与える。分類上の広がりと問題の難しさを、それぞれの評価軸で捉える。
5領域で比較手法を上回り、難度の効果は分かれた
Googleは、教師モデルにGemini 2.5 Flash、生徒モデルにGemma-3 4Bを用い、5つの評価領域で領域ごとに最大51万2000件の合成データを生成した。この評価では、広域の網羅性、局所的な多様性、批評処理を組み合わせた全構成が、すべての領域で単純な比較手法を上回った。
一方、難易度を高める効果は領域によって異なった。算数推論の評価用データセットGSM8kでは性能が改善したが、教師モデルの能力が弱かった法律推論の評価用データセットLEXamでは悪化した。データを難しくする設定が、どの領域でも学習性能を高めたわけではない。
データ件数の比較でも、Googleの評価ではSimulaが比較手法より少ない件数で、学習後のモデルにより高い性能をもたらした。生成量を増やすだけでなく、生成するデータの性質を調整する構成が、学習性能の改善につながった。