Technology
100万トークンのAttentionカーネルで全領域参照比最大7.6倍のプリフィル高速化
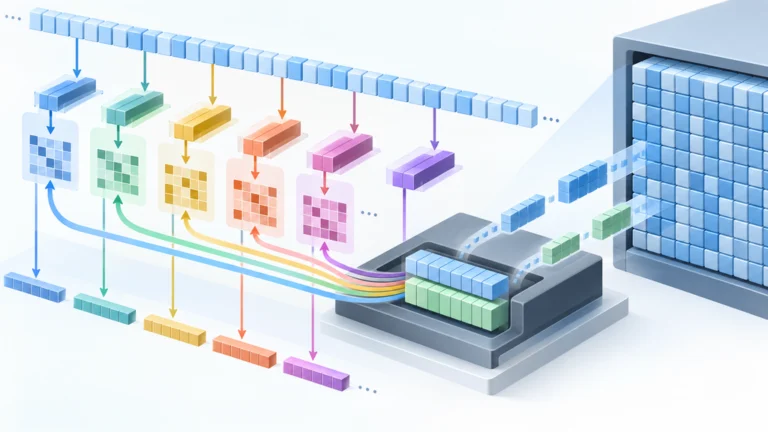
履歴を固定サイズへ圧縮し、必要な領域だけをブロック単位で参照する長文AIモデルが登場した。100万トークン条件の公開ベンチマークでは、Atten…
TOPIC
履歴を固定サイズへ圧縮し、必要な領域だけをブロック単位で参照する長文AIモデルが登場した。100万トークン条件の公開ベンチマークでは、Atten…
LLMのAttentionでKVヘッドを共有するクエリーヘッド数を増やしても、入力処理時間はほぼ変わらない。NVIDIAの測定では共有数を1から…