TOPIC
Mixture of Experts(MoE)
AI
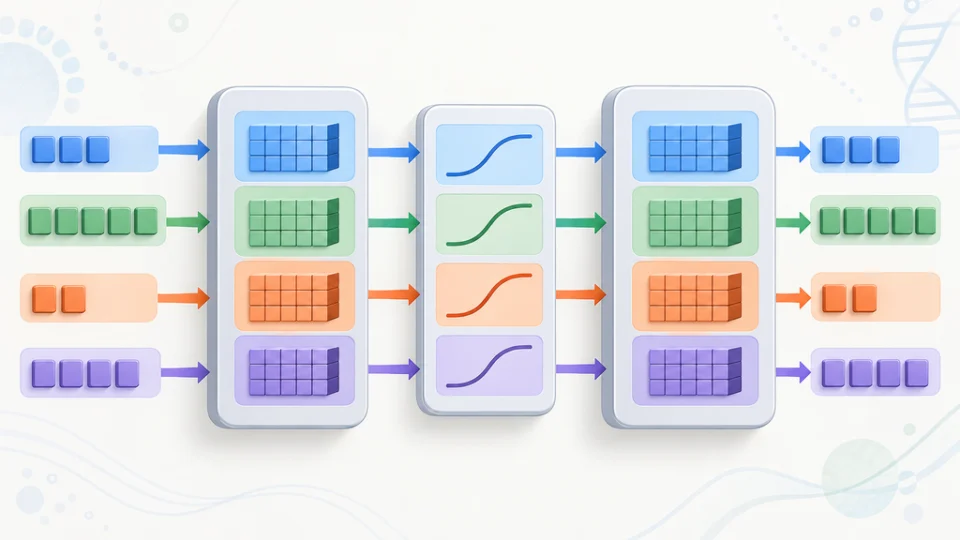
MoE学習レシピ、8基のB200でHugging Face実装の最大2.21倍の処理量
MoEモデルの学習で、Expertごとに分かれていた演算をまとめ、低精度計算と演算融合につなぐレシピが示された。NVIDIAの8基のB200によ…
AI
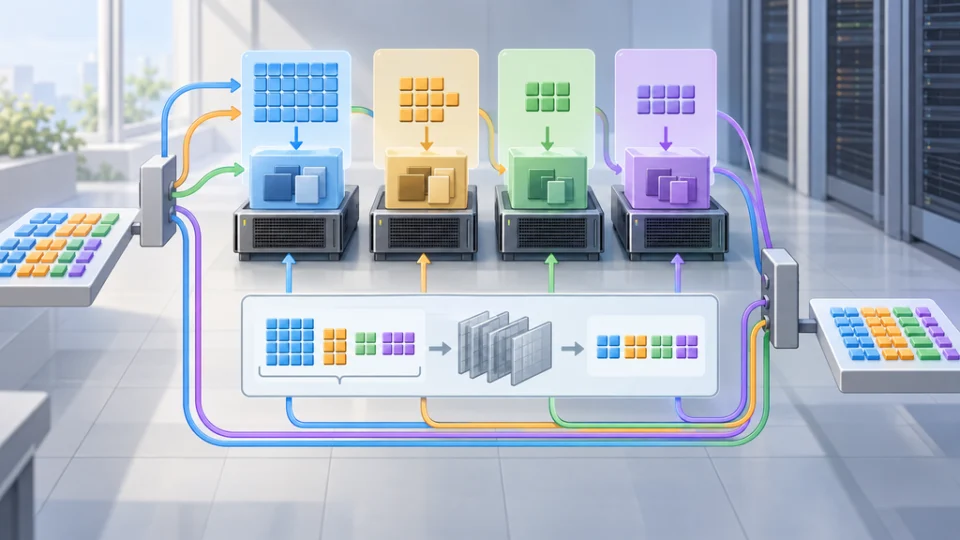
DeepSeek-V3学習のGPU演算性能、最適化前の10.4倍に
Expertごとに届くトークン数が変わるMoEモデルの学習を、JAX向けのGrouped GEMMなどで高速化した。NVIDIAのDeepSee…
AI
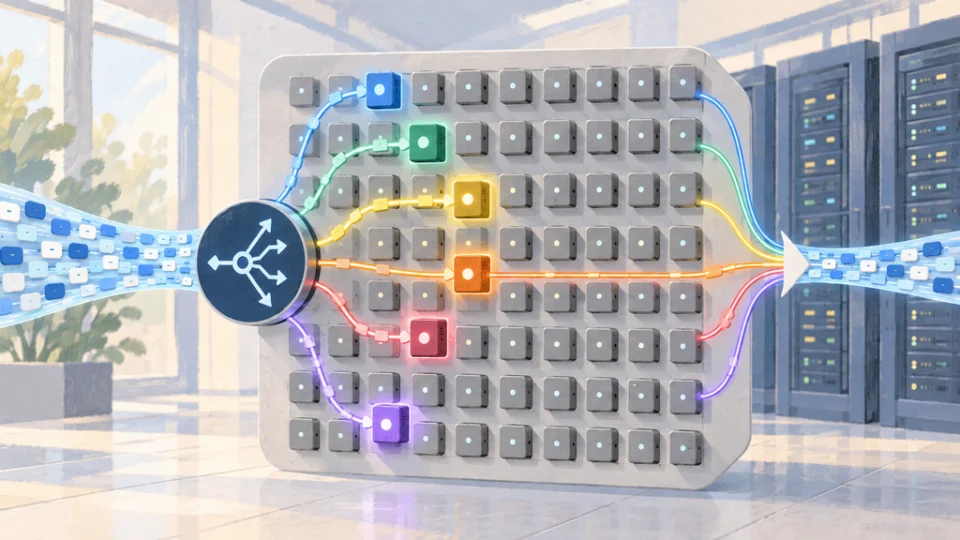
NVIDIAのAIモデル、単一H200でQwen3-30B-A3Bの3.3倍の推論処理量
AIモデル「Nemotron 3 Nano」は、MambaとTransformerを組み合わせた構成に疎なMoEを導入し、処理時に稼働する部分を…