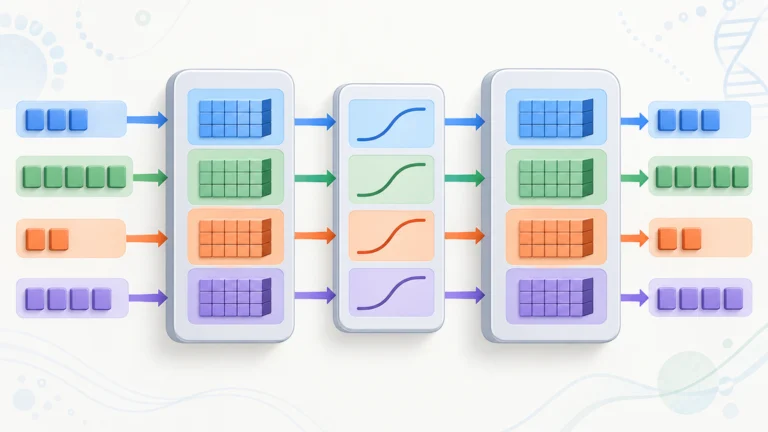
AI MoE学習レシピ、8基のB200でHugging Face実装の最大2.21倍の処理量 MoEモデルの学習で、Expertごとに分かれていた演算をまとめ、低精度計算と演算融合につなぐレシピが示された。NVIDIAの8基のB200によ… 2026.09.27