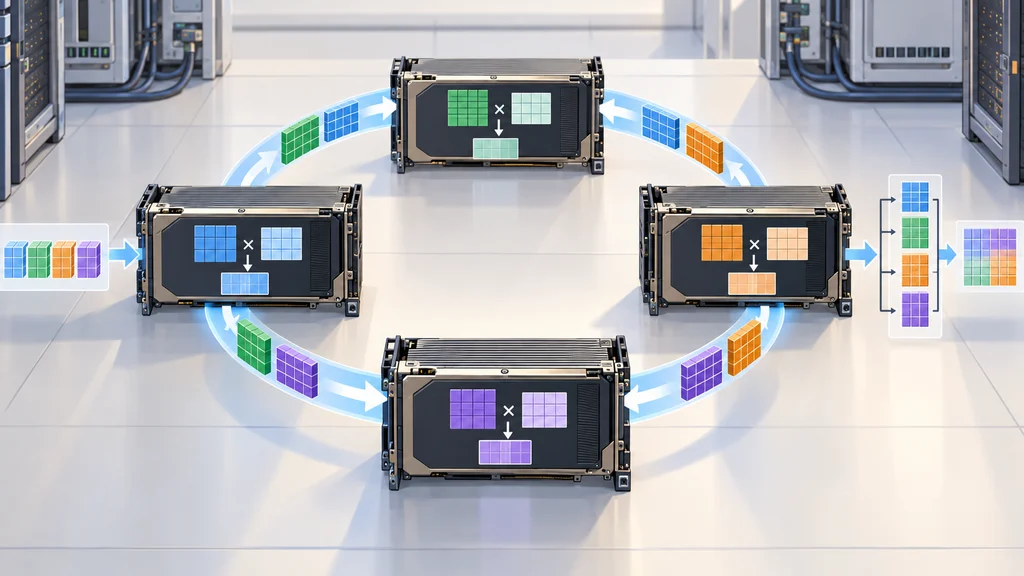
AI推論ソフトのTensorRT 11.0は、GPU間の集合通信を実行系に組み込み、複数GPUでの推論に対応した。モデルの重みを分ける方法に加え、長い入力系列を分けてAttentionを計算する方法も扱える。
複数GPUへの配置をTensorRTの実行系に組み込む
NVIDIAは、AI推論ソフトTensorRT 11.0に複数GPUでの推論機能を導入した。Torch-TensorRTと組み合わせると、PyTorchモデルをPyTorchの実行環境外で動かす形式に変換し、複数GPUへ配置できる。
複数GPUで一つの推論を進めるには、分割したデータや計算結果をGPU間で交換する必要がある。その受け渡しをTensorRTの実行系で扱うことが、今回の機能追加の中心となる。
NCCLの集合通信が分割した計算をつなぐ
GPU間通信にはNVIDIA Collective Communications Library(NCCL)を利用する。NCCLは接続構成に応じて通信経路を選び、TensorRTはその仕組みを複数GPUでの推論に使う。
対応する集合通信には、部分結果を集約するAllReduce、各GPUのデータを集めるAllGather、GPU間でデータを交換するAlltoAllなど、計8種類が含まれる。モデルや入力の分け方に合わせて、必要な受け渡しを推論処理へ組み込める。
層の重みを分けて部分結果を結合する
テンソル並列では、一つの層の重みを複数GPUに分ける。各GPUが担当部分の行列計算を行い、その部分結果を集合通信で結合して層の出力を得る。
一つのGPUのメモリーに層の重みが収まらない場合、この分割によってGPUごとの重みの保持量を減らせる。TensorRTの複数GPU推論は、こうした層内部の分割を実行するための通信を扱う。
入力系列を分けて長いAttentionを処理する
コンテキスト並列では、層の重みではなく入力系列をGPU間で分割する。各GPUは担当する系列の一部分を処理し、Attentionで系列全体を参照するために必要なデータを集合通信で受け取る。
AllGather KV方式では、各GPUが担当するクエリに対して、ほかのGPUが保持するキーと値を集めて計算する。これにより、クエリ側の計算を分担しながら、各GPUが系列全体を参照できる。
キーと値の渡し方で通信とメモリー使用量が変わる
Ring Attentionは、キーと値をGPU間で環状に流し、各GPUが担当するクエリの計算を進める。オンラインsoftmaxを用いるため、系列全体のキーと値を各GPU上に展開する必要がない。
別の方式であるDeepSpeed Ulyssesは、系列を分けた後、Attentionの計算前にクエリ、キー、値をAlltoAllで交換する。TensorRTが対応する集合通信は、このように異なるデータの分割・交換方式を支える。