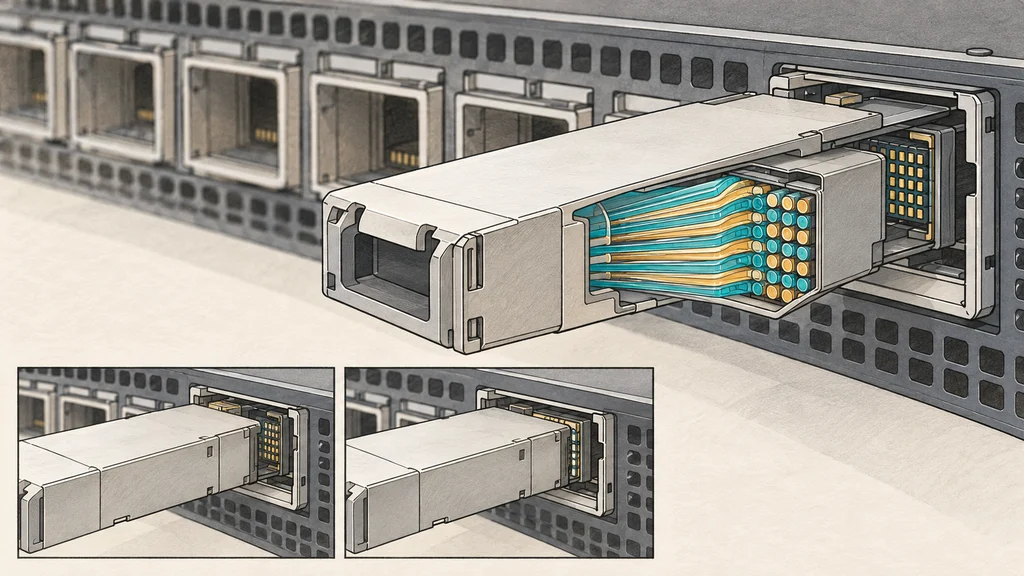
AI計算基盤向けの着脱式光モジュールUSFPは、既存のOSFP相当の実装面積に16本の全二重レーンを収め、各レーンで400Gb/sの電気信号を扱う計画だ。接続密度を高めるため、挿入後に高速接点を接続する二次元配列コネクターを採用する。
レーン数と速度を倍増させ、同じ面積に帯域を収める
NVIDIAとCiscoが開発を計画するUSFP(Ultra-Dense Small Form Factor Pluggable)は、AI計算基盤向けの着脱式光モジュールの新しい形状だ。初期のトランシーバーは、既存の光モジュール形状OSFPと同程度の実装面積に、送受信を同時に行う全二重レーンを16本収める計画である。
比較対象となるレーン当たり200Gb/sの着脱式モジュールから、レーン数と各レーンの帯域をそれぞれ2倍にする。NVIDIAとCiscoは、この組み合わせによって帯域と前面パネルの帯域密度を4倍とし、ネットワーク階層を増やさずに接続する1.6Tb/s端点を増やせるとしている。
高速接点を挿入後につなぐ二段階の接続
高密度のレーンを接続するUSFPのコネクターは、接点を二次元配列に配置する。モジュールの挿入と高速接点の接続を二段階に分け、モジュールを挿入してから高速接点を接続する構造を採る。
NVIDIAとCiscoは、この接続順序によって接点の摩耗を抑え、信号品質を改善し、挿入に必要な力を予測しやすくするとしている。このコネクターは、将来32本以上の全二重レーンへ拡張できる設計でもある。
電力効率と100Wの放熱を別々に扱う
帯域を増やす設計では、データ転送の電力効率も比較対象となる。NVIDIAとCiscoは、USFPの電力効率をレーン当たり200Gb/sの着脱式モジュールの約1.3倍としている。帯域密度4倍という値とは別に、電力当たりに転送するデータ量の改善を示す主張だ。
一方、モジュールの放熱設計は最大100Wに対応する。トランシーバー内部に別個の専用冷却回路を組み込む必要がない設計であり、100Wは電力効率の比較値とは異なる熱設計上の条件である。
複数メーカーで接続部品を開発する
このモジュール形状を支える部品の開発では、NVIDIAとCiscoが接続部品メーカーのTE Connectivity、Amphenolと協力している。対象はモジュールを収めるケージ、コネクター、モジュールであり、共通の形状に沿って複数の供給元が開発を進める。
NVIDIAとCiscoは、コミュニティ主導のマルチソースプロジェクトを通じて、USFPの公開業界仕様を作成する計画だ。部品開発での協力は進行中で、公開仕様の作成はこれからの段階にある。