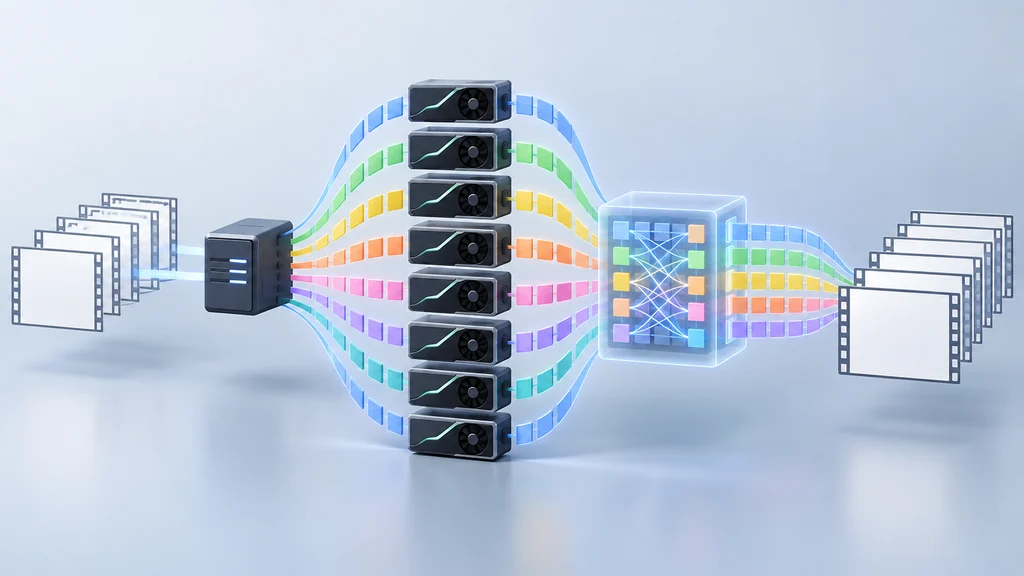
動画生成AIの重いTransformer処理を、1つの推論窓口から複数GPUへ分散できるようになった。NVIDIAの測定では、動画1件の生成時間がGPU1基の156.6秒から8基の34.2秒に短縮された。
単一の推論窓口が複数GPUの実行を引き受ける
NVIDIAは、推論サーバーTriton Inference Serverの26.07リリースで、TensorRTバックエンドに複数GPUでの推論機能を追加した。複数GPU構成では、1つのKIND_MODELインスタンスが参加するGPUを管理し、GPUごとのTensorRT実行コンテキスト、CUDAストリーム、GPU間通信用のNCCL通信器を作成する。
アプリケーションは単一のgRPCモデル窓口へ要求を送る。各GPUで動く処理の調整はサーバー側が担うため、アプリケーションがGPUの各ランクを直接制御する必要はない。
動画トークンの分割軸をAttentionの前後で切り替える
分散処理のグラフは、配備前にTensorRTの実行プランへ組み込まれる。サーバー側の設定は完成した分散プランを有効化し、動画生成モデルCosmos 3 Nanoの実演では44,160個の動画トークンを最大8基のGPUへ分けた。
8基の構成では、各ランクがAttention以外の処理で5,520個の動画トークンを担当する。Ulyssesと呼ぶ方式はAttentionの前後で分割軸を切り替え、各ランクが重ならない一部のヘッドについて動画トークン列全体を処理する。
70回のTransformer呼び出しを既存の生成手順につなぐ
実演では、36層のノイズ除去Transformerを推論サーバーが処理する。生成手順を組み立てるDiffusersは、プロンプト、スケジューリング、動画の復号などを引き続き制御する。
ノイズ除去は35ステップで進み、各ステップで条件なしとプロンプト付きの予測を順に要求する。このため、動画1件の生成中にTransformerへの推論サーバー呼び出しが計70回発生する。
生成全体では4.58倍、Transformer呼び出しでは6.09倍
NVIDIAは同じ8基構成のシステムを使い、GPU1基、2基、4基、8基を比較した。出力は共通して1280×720画素、189フレーム、35回のノイズ除去ステップとした。
測定された動画生成全体の平均所要時間は、GPU1基の156.595秒から8基の34.183秒となり、速度比は4.58倍だった。Transformer呼び出しに要した平均時間は146.192秒から23.993秒となり、速度比は6.09倍だった。
測定対象の呼び出し経路以外に要した時間は、各構成で10.2~10.5秒の範囲だった。生成全体の速度比がTransformer呼び出しの速度比を下回る条件も、この内訳から読み取れる。