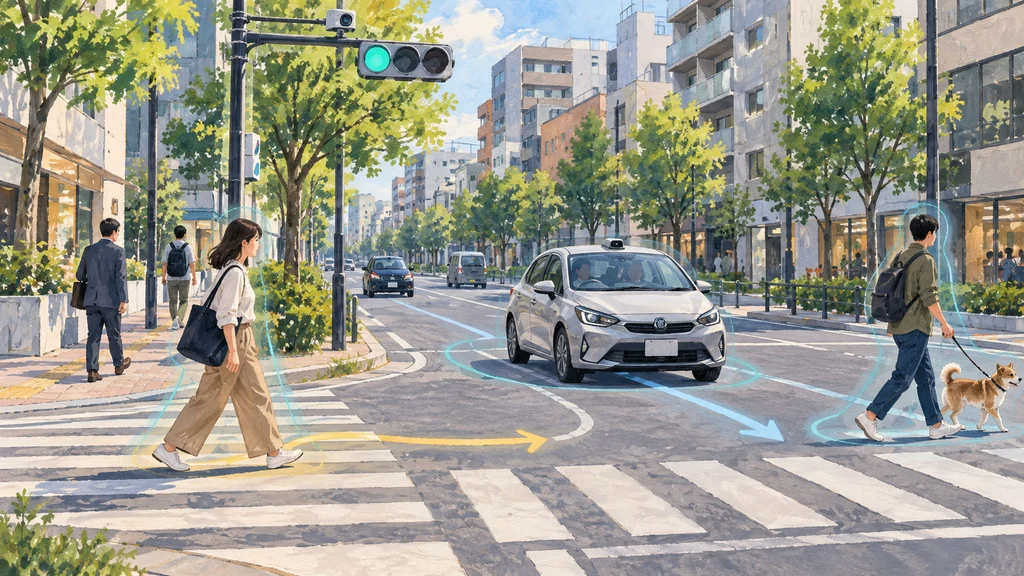
街の映像・行動・環境データを統合するAI基盤モデルが、実証都市Woven Cityで利用されている。視覚理解に行動予測と運転支援を組み合わせる安全支援システムも公開され、車両や信号機のカメラデータから歩行者と運転者へ情報を届ける構成を取る。
映像だけでなく行動と環境のデータを統合
都市向けAI基盤モデルWoven City AI Vision Engineは、カメラ映像、モビリティシステム、利用者からの入力に由来する視覚・行動・環境データを統合する。開発元のWoven by Toyotaによると、この基盤モデルは現実の状況をリアルタイムに理解して対応する能力を備えるという。
統合したデータからパターンを識別し、潜在的なリスクを検出する。Woven by Toyotaは、この処理によって接続されたシステム間の協調動作が可能になるとしている。
視覚理解に行動予測と運転支援を接続
この基盤モデルの能力を安全支援へつなぐのが、Woven City Integrated ANZEN Systemだ。視覚理解を担うモデルに、人の行動を予測するWoven City Behavior AIと、運転支援を担うWoven City Drive Sync Assistなどを組み合わせる。
行動予測AIは、人の行動パターンを解釈して次の行動を予測する。運転支援AIは、運転者のニーズと周囲の状況に基づいて支援を提供する。
車両と信号機の映像から道路利用者へ情報を届ける
安全支援システムの入力には、車両や信号機のカメラデータを使う。Woven by Toyotaによると、その分析を通じて動きを理解し、行動を予測した情報を歩行者と運転者に提供できるという。
UCC Japanとの実証で基盤モデルを利用
AI Vision Engineは、Woven Cityに参画する企業UCC Japanとの実証プロジェクトですでに利用されている。トヨタ自動車とWoven by Toyotaは、この基盤モデルの導入先をWoven Cityの外へ広げる計画も示している。